生成式 AI 与基本面投资:哥大 Ehsan Ehsani 课堂讲义(中文整理)
来源说明:本文课件图片来自但斌(东方港湾董事长)2026 年 10 月 4 日(北京时间)连发的四条微博,均为课堂现场拍摄的英文 PPT(第四帖为中英双语页)。中文翻译与整理由本站完成,不代表讲者或但斌的观点;翻译尽量忠实,人名、公司名、术语保留英文括注,看不清的字标【模糊】,没有补写。
- (一)02:10 https://www.sina.cn/weibo/detail/5350118242911753.html(第一部分)
- (二)02:53 https://www.sina.cn/weibo/detail/5350128898540191.html(第二部分)
- (三)04:40 https://www.sina.cn/weibo/detail/5350155941577059.html,标题「AI 不是替代分析师,而是让三人团队跑出一百亿的资产」(第三部分;「一百亿」的说法见第三部分说明)
- (四)06:54 https://www.sina.cn/weibo/detail/5350189625771934.html,长文「百年计算能力曲线:在漫长蛰伏后,AI 正迎来陡峭的爆发」(第四部分,出处存疑)
课程信息
| 项目 | 内容 |
|---|---|
| 课程 | Generative AI In Fundamental Investing and Asset Management(生成式 AI 在基本面投资与资产管理中的应用) |
| 主讲 | Ehsan Ehsani |
| 项目 | 哥伦比亚大学商学院(Columbia Business School)GVIP Program |
| 课件日期 | 封面页标注 October 3, 2026(美国当地时间) |
| 记录者 | 但斌(东方港湾董事长),2026-10-04 北京时间连发四条微博 |
核心观点摘要
- 基本面分析师的工作有 80% 以上是结构化、可重复、相当机械的流程,投资者约 30% 的时间花在不创造价值的手工活上。AI 能把行业比价(industry comps)这类工作从几小时压到几秒。
- 通用模型在核心金融分析任务上大约「十次对六次」(54%–63%)。GPT-5 分析 AEO 财报会时编造了引语、给错了门店数。同一个前沿模型接上结构化文件数据源,准确率是 94.2%;放到开放网络上的网搜助手只有 33.8%。差别只在「让它读什么」。
- 「模型是最不具专有性的一层」。Oakcliff Capital 3 人管理 3.6 亿美元,它的智能体 Marvin 把公司的投资框架、记忆和 wiki 做成专有层,每次输出都回写进知识库,让知识像复利一样积累。
- 信念是一块块拼起来的(scuttlebutt),检索不出来。AI 生成的「论点形状的物体」读的是市场共识,不是公司本身。alpha 来源可能从 14 项压缩到 5 项,剩下的是判断、结构性优势和时间优势。
- 落地顺序:先写研究手册(playbook),再选错误代价低、每天都做的环节建第一个 agent。每个 agent 都要有指定的人工检查点、已知的失效模式和 90 天成功标准。(但斌帖四另附了算力、数据、模型能力、云基础设施四重指数增长的课件,出处存疑,见第四部分。)
页序说明
- 排序:先按四条微博的发布时间(一→二→三→四),帖内再按内容逻辑排。第(三)帖课件左下角有页码(21、29、36、39、40、45、54、55),按页码排序。第(一)帖图片在微博里的顺序和讲课逻辑不一致,这里按课程目录(Agenda)重排:封面 → 目录 → 现状挑战 → AI 的影响 → 落地案例。
- 共收录 33 页,包括 2 张现场照(封面、An AI Analyst in a Weekend),投影内容裁切放大后可以辨认。
- 跳过 2 张:第(一)帖中另有 2 张现场照,一张投影是演示软件的编辑/演讲者视图,没有可辨认的课件文字;另一张投影是 PPT 编辑视图,主画面与「An AI Analyst in a Weekend」重复。
- 其他说明:
- P25「四种复合式指数增长现象」是但斌制作的中文拼图,不是原课件页。其中三格与 P26、P31、P29 重复,但「云」那一格只在这张图里出现,所以作为第四部分的总览页收录。
- 存疑:第四部分(帖四配图)很可能出自另一堂课,推测是 Hod Lipson 的讲座,而不是 Ehsani 这堂课,详见第四部分开头的说明。
第一部分 · 现状与挑战(帖一)
P1 封面 · Generative AI In Fundamental Investing and Asset Management(生成式 AI 在基本面投资与资产管理中的应用)
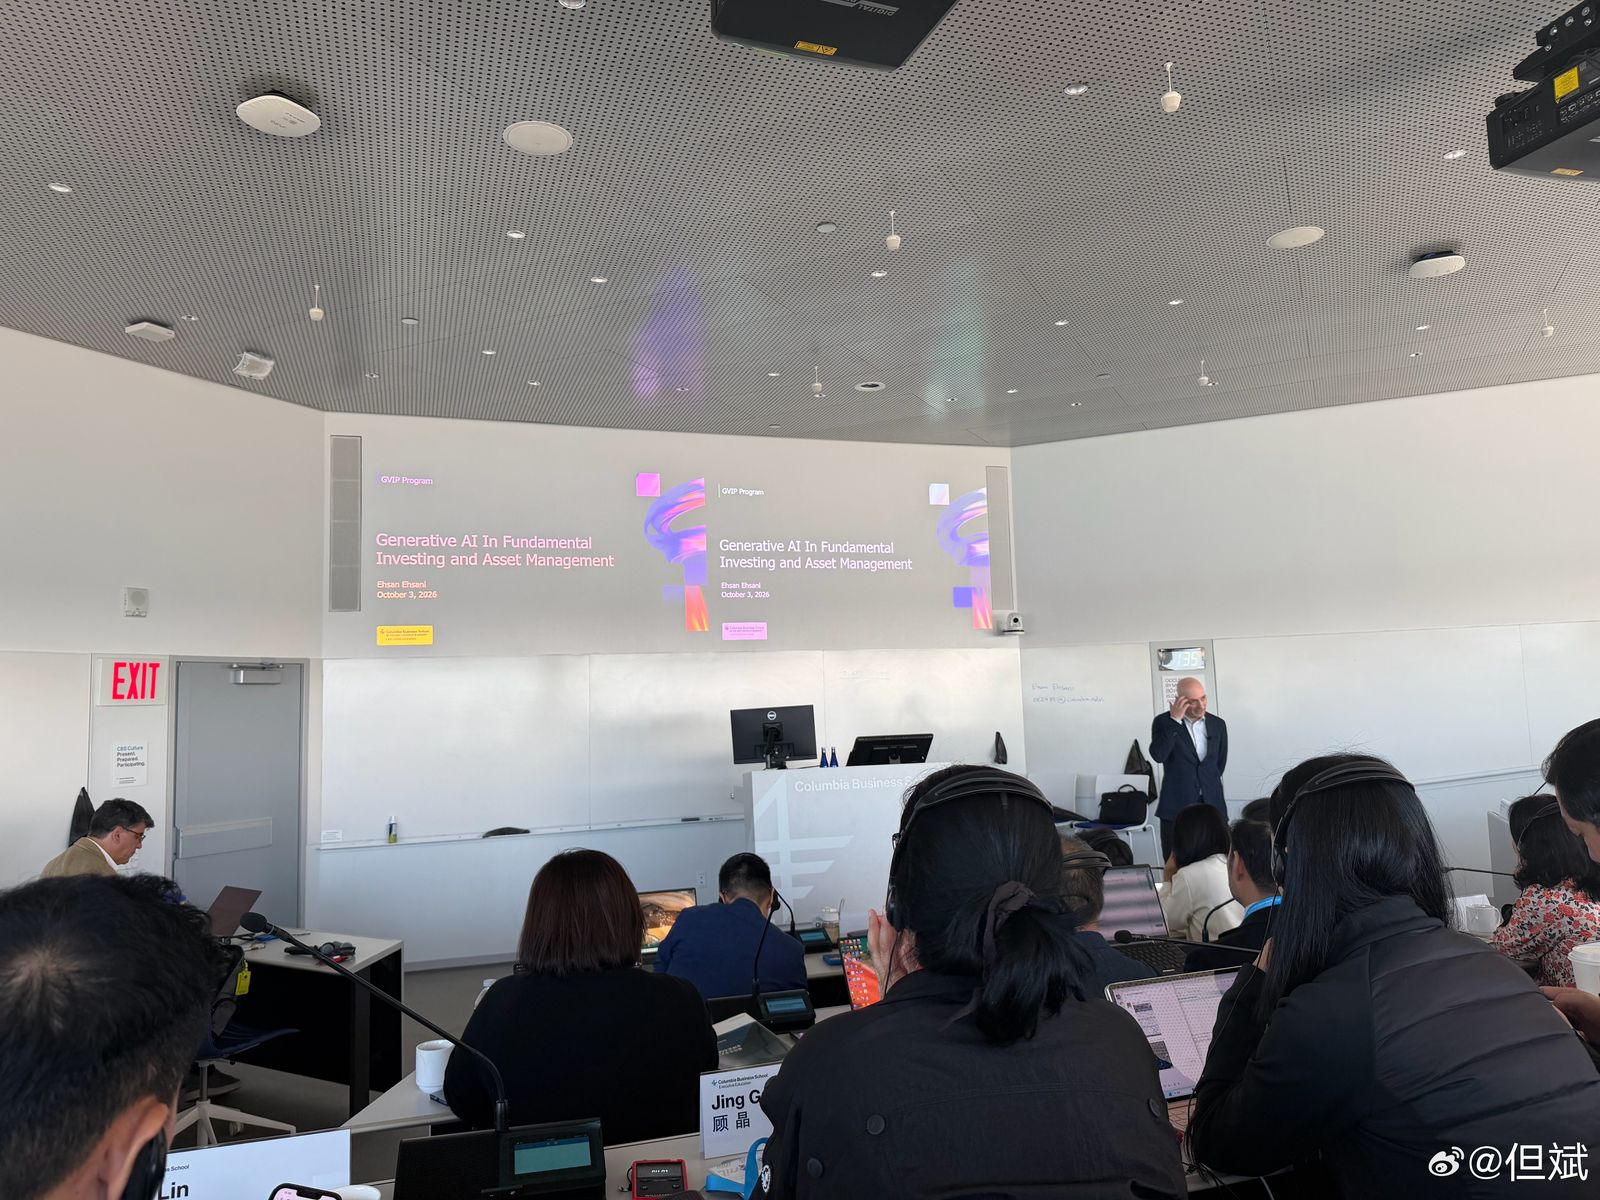
翻译:GVIP 项目(GVIP Program)|生成式 AI 在基本面投资与资产管理中的应用|Ehsan Ehsani|2026 年 10 月 3 日|左下角是哥伦比亚商学院高管教育(Columbia Business School Executive Education)标志。
图表说明:现场照,教室里两块投影同时显示封面,右侧站着主讲人。
要点:这门课讲 GenAI 怎样落到「基本面投资」这个具体场景里,不是泛泛介绍 AI。
P2 课程目录(Agenda)
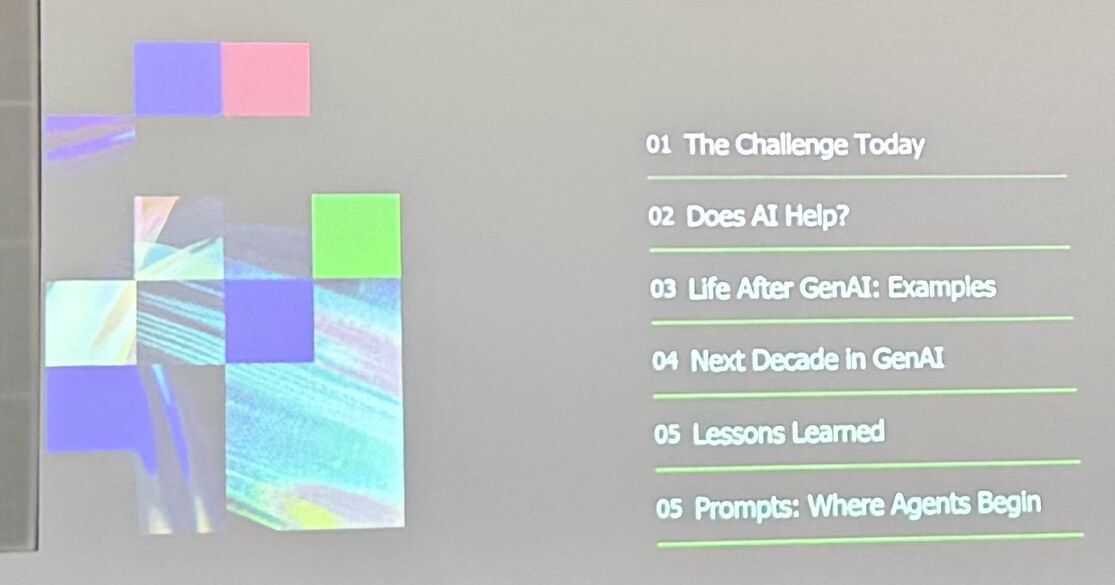
翻译: 01 当下的挑战(The Challenge Today) 02 AI 有帮助吗?(Does AI Help?) 03 GenAI 之后的生活:案例(Life After GenAI: Examples) 04 GenAI 的下一个十年(Next Decade in GenAI) 05 经验教训(Lessons Learned) 05 提示词:智能体从这里开始(Prompts: Where Agents Begin)(原页两个条目都编号「05」,照录)
图表说明:左边是彩色方块拼贴,右边是六条目录,每条下面有绿色分隔线。
要点:整堂课的逻辑是「痛点 → AI 能不能帮 → 实例 → 未来 → 教训 → 动手做 agent」。
P3 效率挑战(Efficiency Challenge)
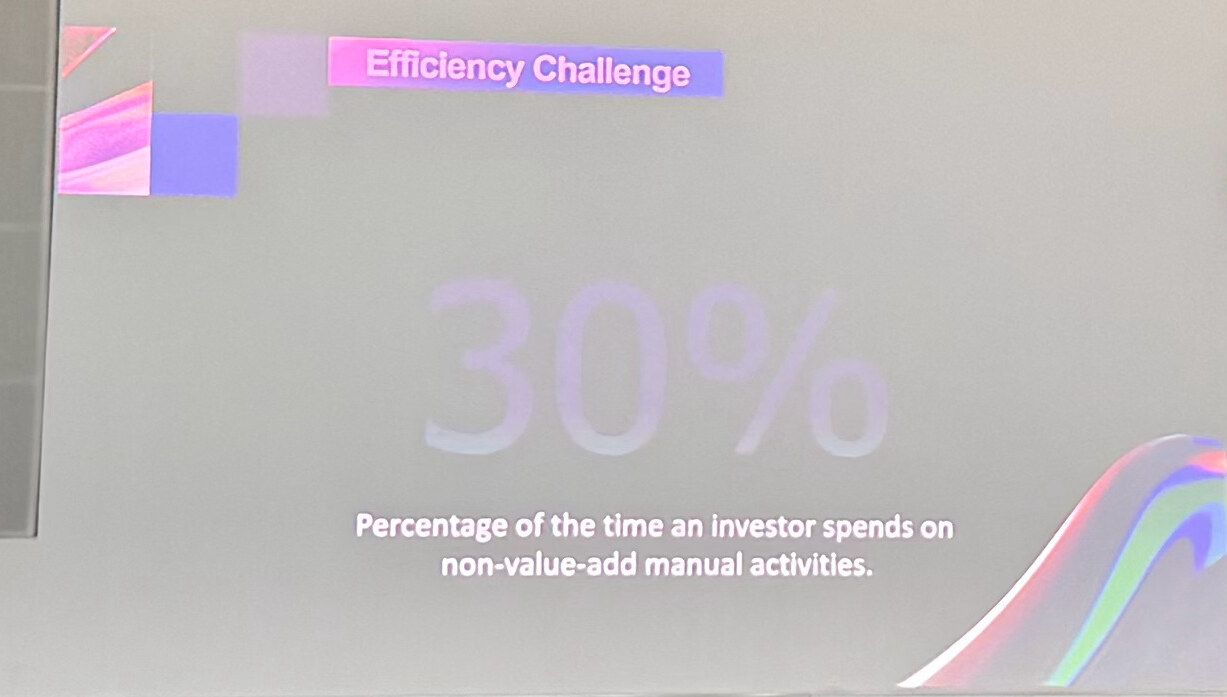
翻译:30%:投资者花在不创造价值的手工活(non-value-add manual activities)上的时间占比。
图表说明:大字号数字页,页面中央是半透明的「30%」。
要点:近三分之一的时间被手工活占用,这是 AI 最直接的切入点。
P4 常见现状:信息碎片化(Common Setup: Fragmented Information)
翻译:三个问题:① 系统互不相连(Disconnected Systems);② 手工、低效的整合(Manual and Sub-Optimal Integration);③ 定性信息来源(Qualitative Sources)。
图表说明:三个图标,依次是节点连线、两个数据库之间的循环箭头、方块矩阵。
要点:效率低的根源是数据分散在不同系统里、靠人工拼接,而且大量信息是非结构化的定性材料。
P5 AI 的影响(Impact of AI):alpha 来源的压缩
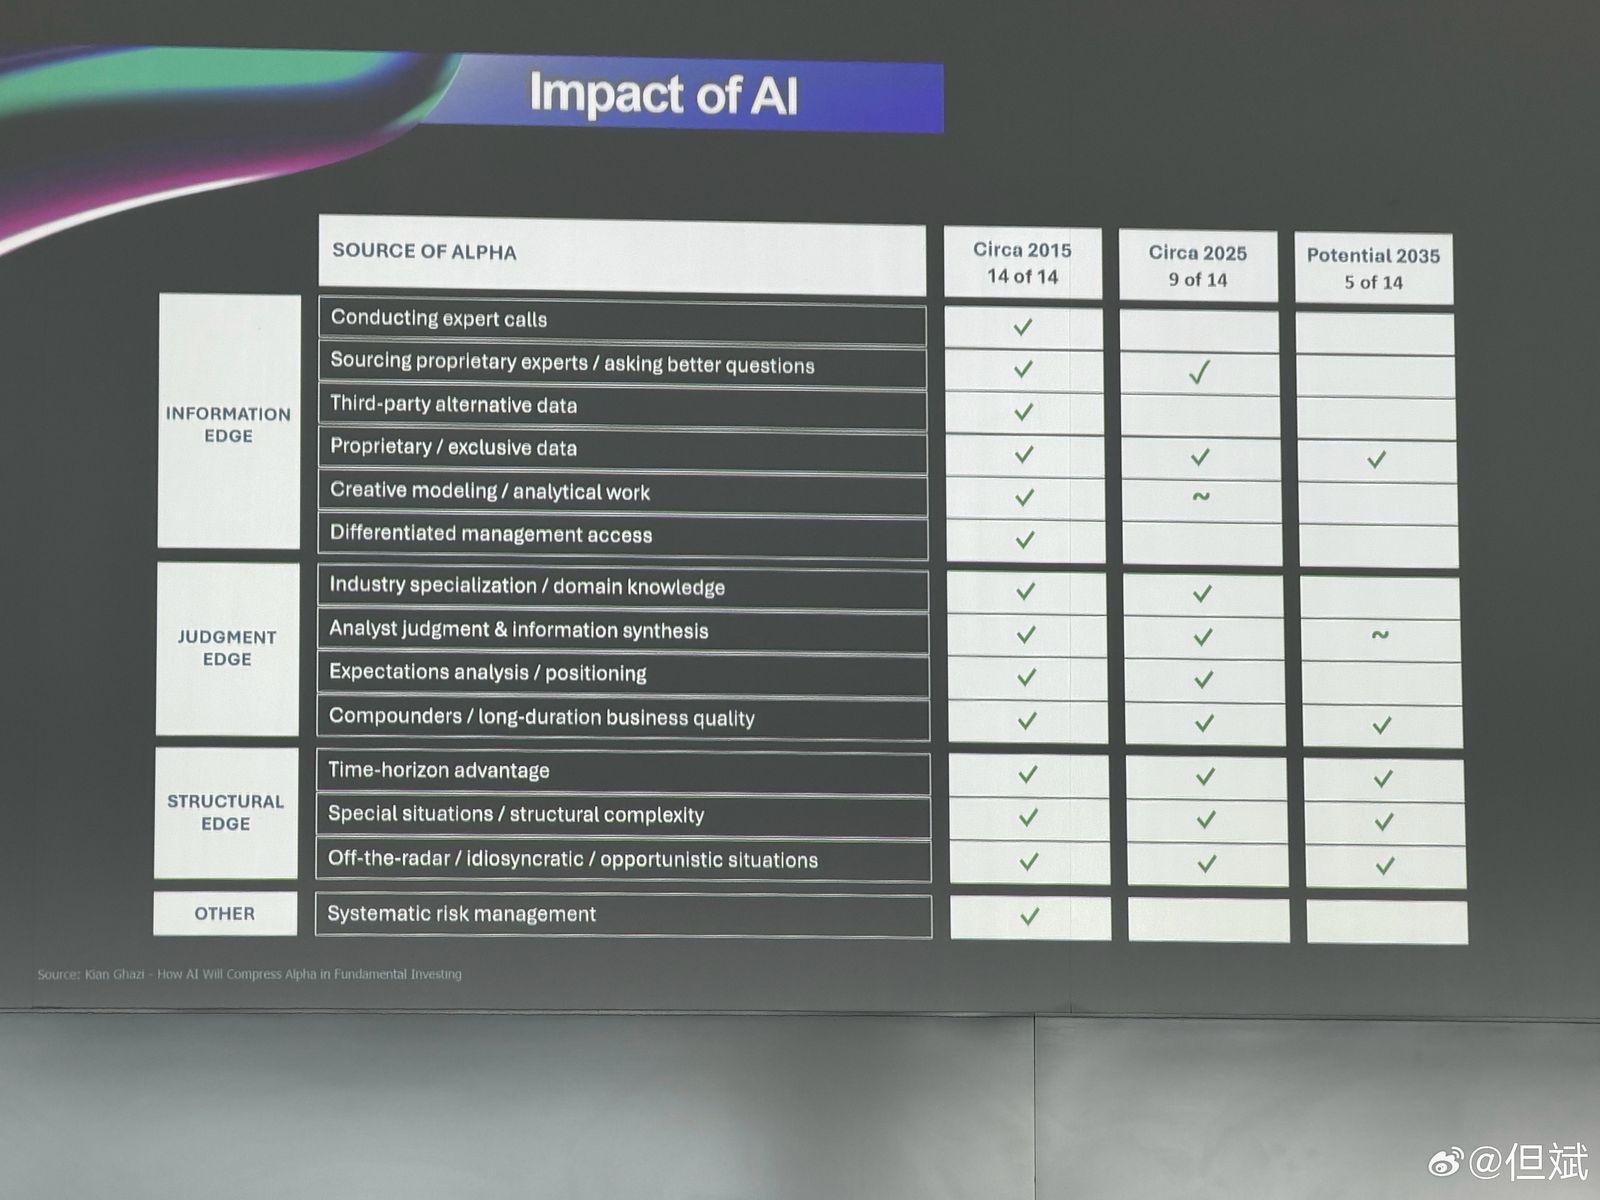
翻译(表头:alpha 来源(SOURCE OF ALPHA)|约 2015 年:14 项中 14 项|约 2025 年:14 项中 9 项|2035 年预期:14 项中 5 项):
| 类别 | alpha 来源 | ~2015 | ~2025 | 2035 预期 |
|---|---|---|---|---|
| 信息优势(Information Edge) | 做专家访谈(Conducting expert calls) | ✓ | ||
| 寻找独家专家 / 问更好的问题(Sourcing proprietary experts / asking better questions) | ✓ | ✓ | ||
| 第三方另类数据(Third-party alternative data) | ✓ | |||
| 独有 / 排他性数据(Proprietary / exclusive data) | ✓ | ✓ | ✓ | |
| 创造性建模 / 分析工作(Creative modeling / analytical work) | ✓ | ~ | ||
| 差异化的管理层接触(Differentiated management access) | ✓ | |||
| 判断优势(Judgment Edge) | 行业专精 / 领域知识(Industry specialization / domain knowledge) | ✓ | ✓ | |
| 分析师判断与信息综合(Analyst judgment & information synthesis) | ✓ | ✓ | ~ | |
| 预期分析 / 定位(Expectations analysis / positioning) | ✓ | ✓ | ||
| 复利型公司 / 长期商业质量(Compounders / long-duration business quality) | ✓ | ✓ | ✓ | |
| 结构优势(Structural Edge) | 时间维度优势(Time-horizon advantage) | ✓ | ✓ | ✓ |
| 特殊情形 / 结构复杂性(Special situations / structural complexity) | ✓ | ✓ | ✓ | |
| 冷门 / 个股特异 / 机会型情形(Off-the-radar / idiosyncratic / opportunistic situations) | ✓ | ✓ | ✓ | |
| 其他(Other) | 系统化风险管理(Systematic risk management) | ✓ |
来源:Kian Ghazi – How AI Will Compress Alpha in Fundamental Investing(字很小,基本可辨)
图表说明:勾选矩阵,「~」表示部分保留。
要点:信息类优势会被 AI 大量抹平。到 2035 年还站得住的主要是独有数据、复利型公司判断、长期持有和特殊情形这类结构性优势。
P6 每次模型发布都会吃掉一层「套壳」(Every Model Release Eats a Wrapper)
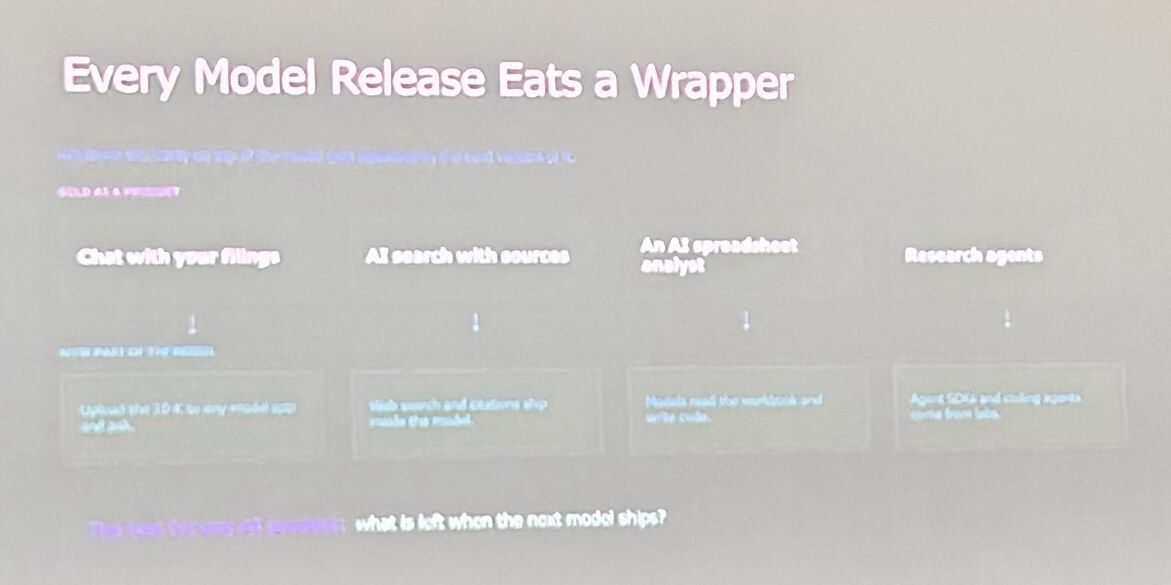
翻译:
- 副标题:【模糊】(大意似为「构建在模型之上的东西会被下一个版本吞掉」,原文无法逐字辨认)
- 上排标签【模糊,疑为 SOLD AS A PRODUCT「曾作为独立产品出售」】:与申报文件对话(Chat with your filings)|带来源引用的 AI 搜索(AI search with sources)|AI 表格分析师(An AI spreadsheet analyst)|研究智能体(Research agents)
- 下排标签【模糊,疑为 NOW PART OF THE MODEL「现已成为模型自带功能」】:
- 把 10-K 上传到任意模型应用里直接提问(Upload the 10-K to any model app and ask)
- 网页搜索与引用已内置于模型(Web search and citations ship inside the model)
- 模型能读工作簿并写代码(Models read the workbook and write code)
- Agent SDK 和编程智能体由模型实验室直接提供(Agent SDKs and coding agents come from labs)
- 以上四行字较小,按可辨程度转写,个别词可能有误
- 底部:【模糊,疑为 The test for any AI product】:下一个模型发布之后,还剩下什么?(what is left when the next model ships?)
图表说明:四列,每列上面是「过去的产品形态」,向下箭头指向「现已被模型吸收」。
要点:只做套壳的 AI 产品没有护城河。值得投入的是模型升级后仍然留得住的东西,比如数据、流程和机构记忆。
P7 一个周末做出 AI 分析师(An AI Analyst in a Weekend)
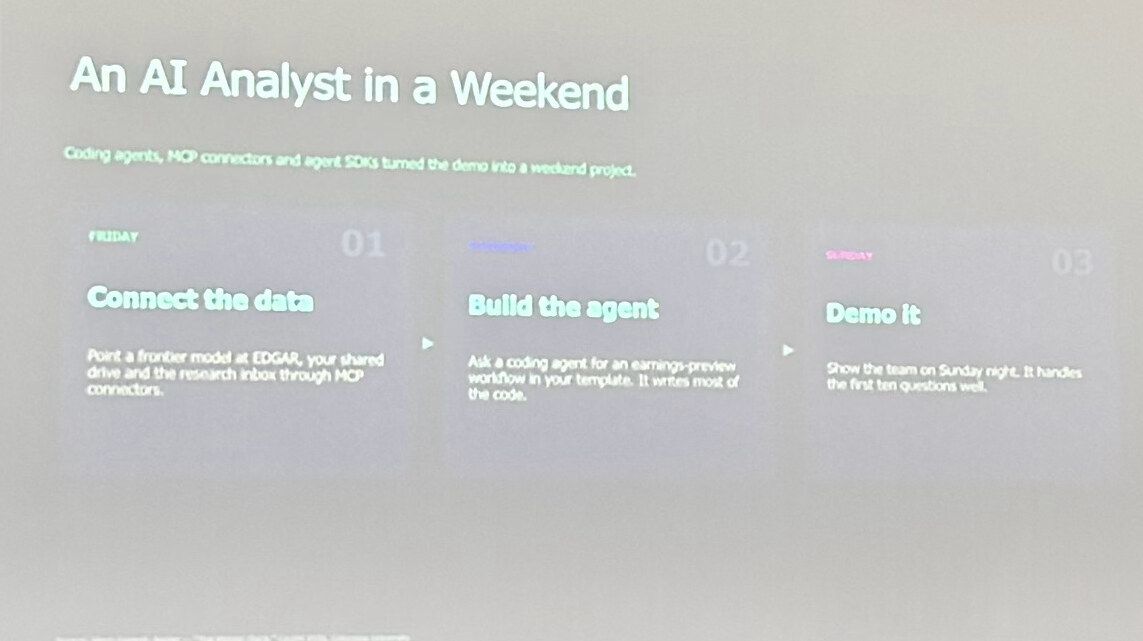
(现场照,投影区域裁切放大)
翻译:副标题:编程智能体(Coding agents)、MCP 连接器(MCP connectors)和智能体 SDK(agent SDKs)把演示变成了一个周末项目。
- 01 周五(FRIDAY),连接数据(Connect the data):通过 MCP 连接器,把前沿模型接到 EDGAR、团队共享盘和研究邮箱。
- 02 【模糊,应为周六】,搭建智能体(Build the agent):让编程智能体按你的模板写一个财报预览(earnings-preview)工作流,大部分代码由它完成。
- 03 周日(SUNDAY),演示(Demo it):周日晚上给团队演示。前十个问题它都能处理得很好。
图表说明:三张卡片,从左到右用箭头连接。
要点:搭一个 demo 的门槛已经低到一个周末。真正难的在后面,也就是第二部分讲的「坏消息」。
第二部分 · 坏消息:通用 AI 的局限(帖二)
P8 现在,说说坏消息……(Now, the Bad News…)
翻译:现在,说说坏消息……
图表说明:过渡页,只有一行大字。
要点:讲完 AI 的潜力,转入它的失败案例。
P9 GPT-5 分析 AEO 财报电话会示例(1/3)(GPT-5 AEO Earnings Call Example)
翻译:
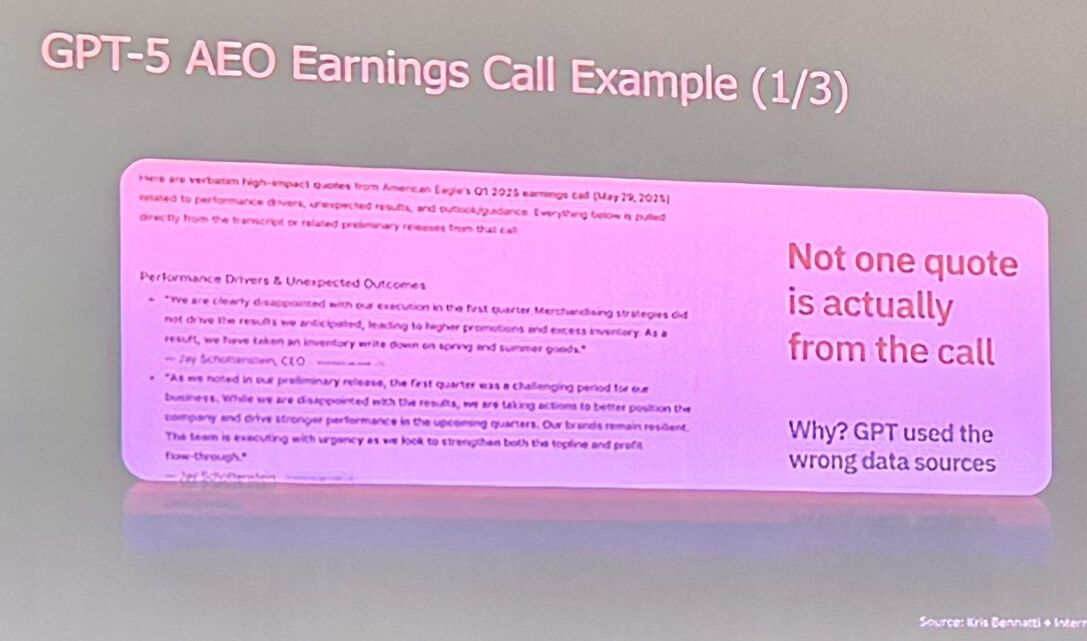
- 截图中 GPT-5 的回答(字小,大致可辨):「以下是 American Eagle(AEO)2025 年第一季度财报电话会(May 29, 2025)中与业绩驱动、意外结果、展望/指引相关的高影响力原话引语。以下内容均直接取自电话会文字记录或相关初步公告。」
- 业绩驱动与意外结果(Performance Drivers & Unexpected Outcomes):「我们对第一季度的执行明显感到失望。商品策略没有带来预期的结果,导致更多促销和库存过剩。因此,我们对春夏商品计提了存货减值。」——Jay Schottenstein,CEO
- 「正如我们在初步公告中提到的,第一季度对我们的业务是一个充满挑战的时期。虽然对结果失望,我们正在采取行动,让公司在接下来几个季度更好地布局、实现更强的业绩。我们的品牌依然有韧性。团队正以紧迫感执行,力求加强营收和利润转化(topline and profit flow-through)。」——Jay Schottenstein【模糊:后续署名小字】
- 以上引语字体很小,个别词按上下文辨认
- 右侧结论:没有一句引语真正出自那次电话会。 原因是 GPT 用错了数据源。
- 来源:Kris Bennatti + 【模糊,被裁切,参照 2/3 页应为 Internal Analysis】
图表说明:左边是 ChatGPT 回答截图(粉色底),右边是红字结论。
要点:通用模型会自信地编造「原话」。对投资研究来说,引语和数字都必须能追溯到原始文件。
P10 GPT-5 分析 AEO 财报电话会示例(2/3)
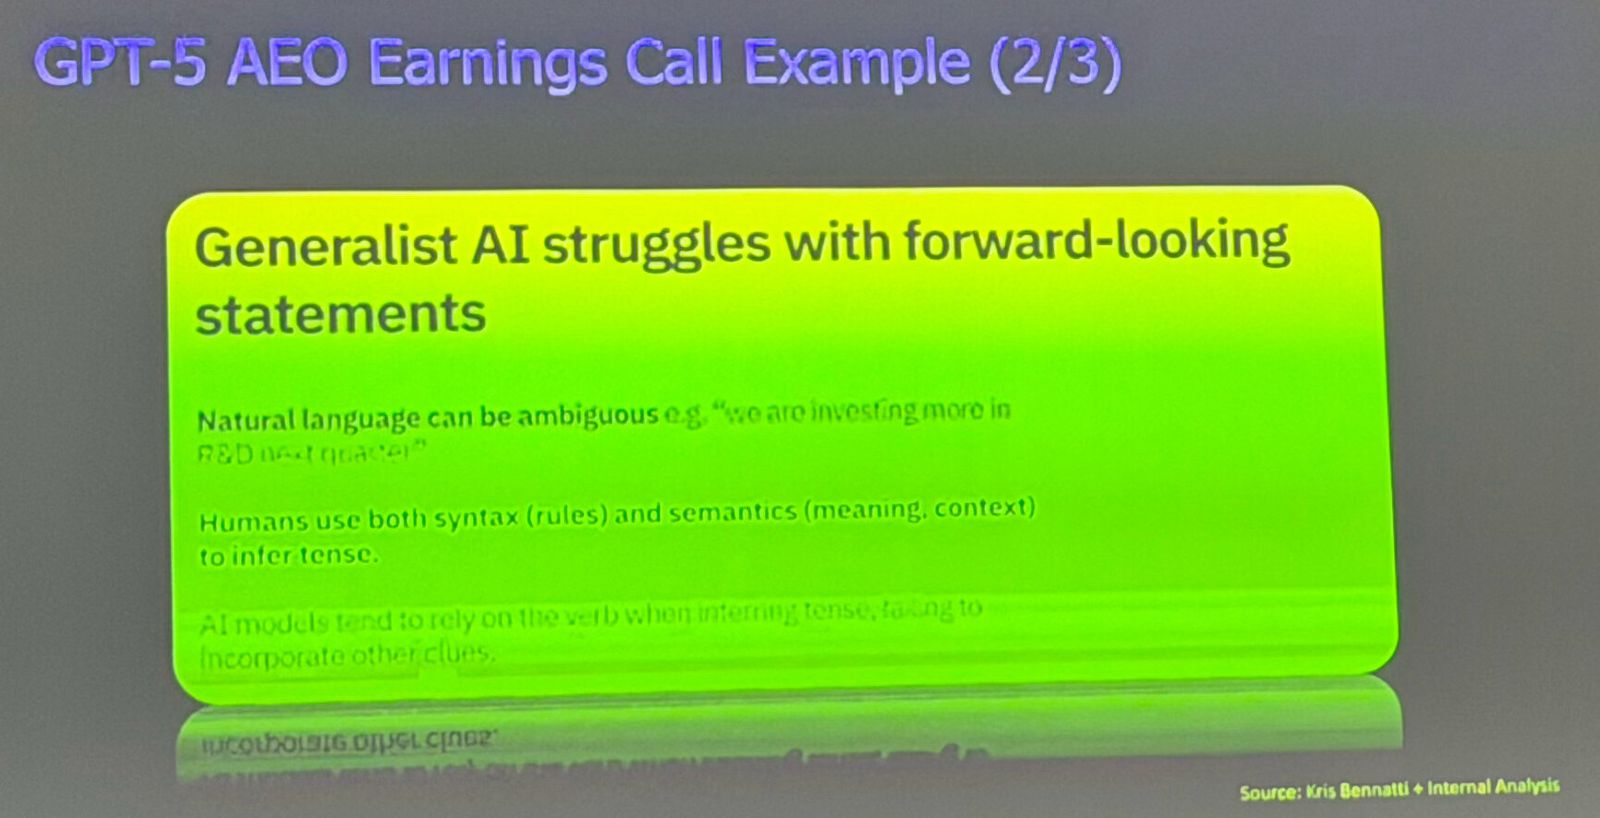
翻译:通用型 AI 难以处理前瞻性陈述(Generalist AI struggles with forward-looking statements)。
- 自然语言可能有歧义,例如「我们下季度将加大研发投入」(“we are investing more in R&D next quarter”)。
- 人类同时用句法(syntax,即规则)和语义(semantics,即含义、语境)来判断时态。
- AI 模型判断时态时往往只看动词,没有结合其他线索。(这一行在投影上偏淡,基本可辨)
- 来源:Kris Bennatti + Internal Analysis
图表说明:荧光绿文本框,下方有倒影。
要点:分清「已经发生」和「计划发生」是解读财报的基本功,通用模型在这一点上会系统性出错。
P11 GPT-5 分析 AEO 财报电话会示例(3/3)
翻译:
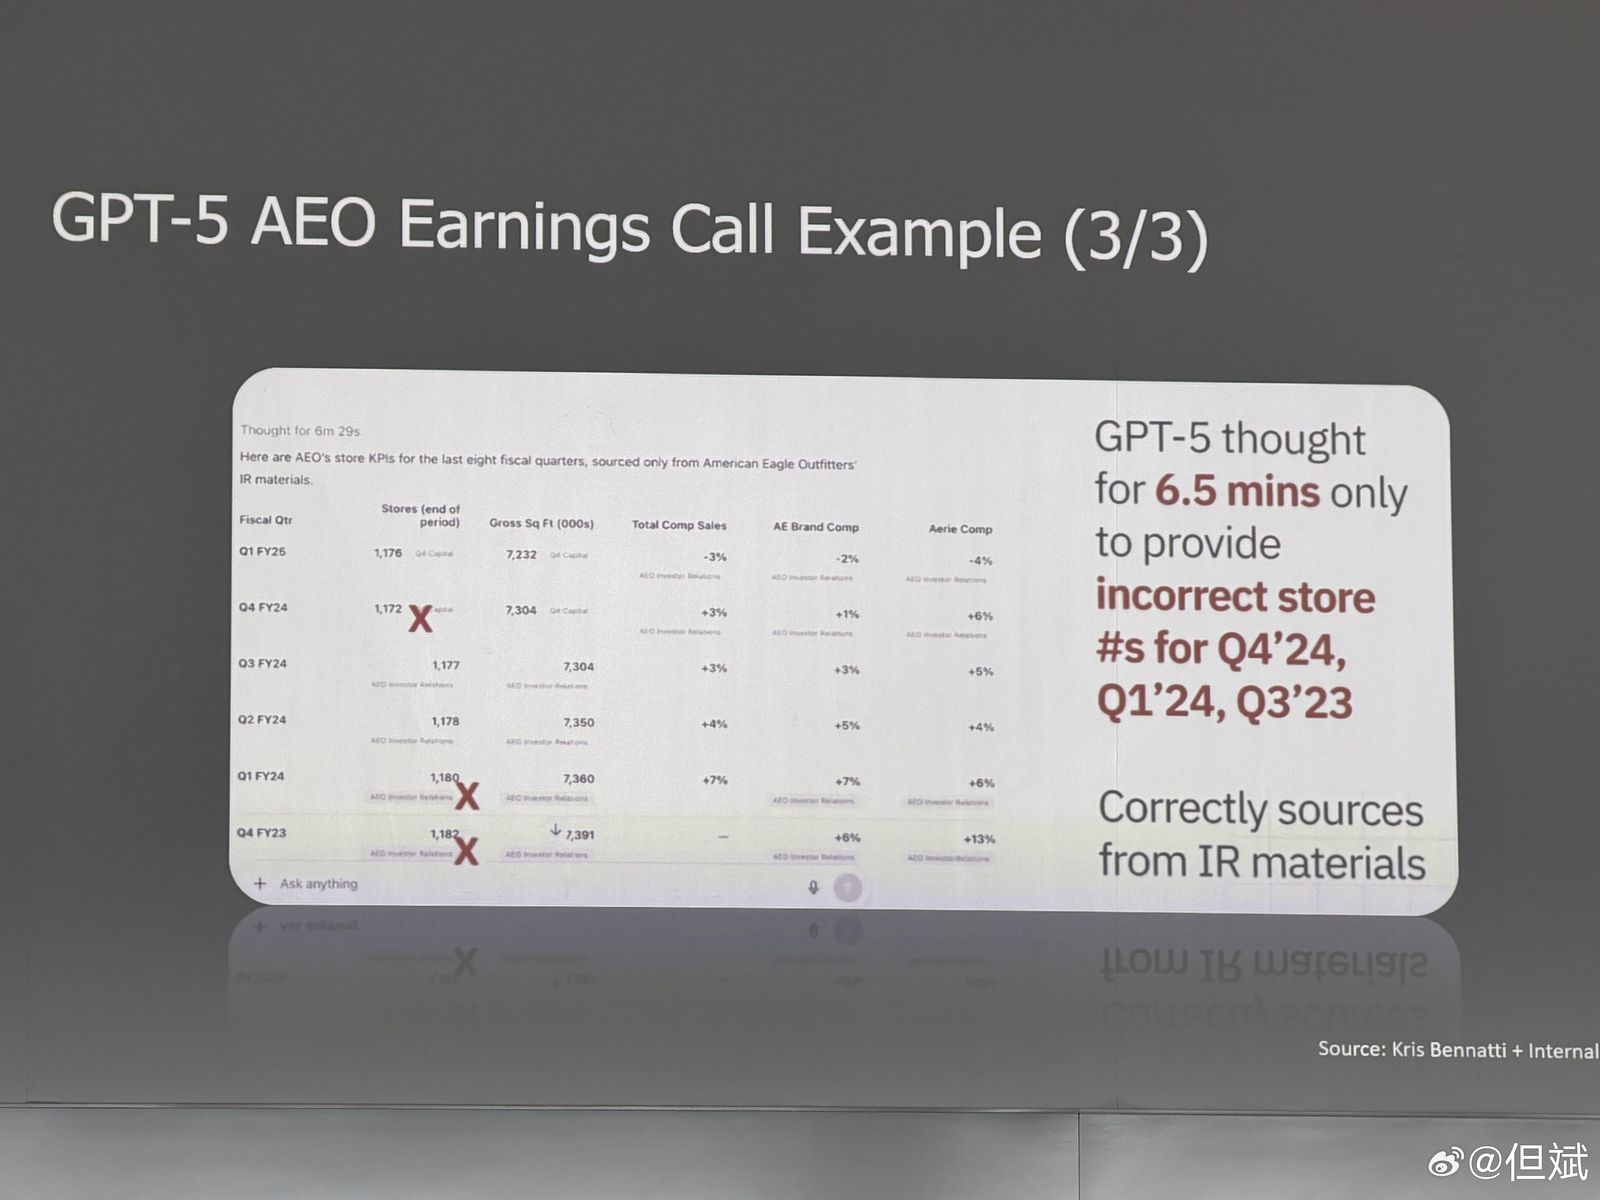
- 截图:「Thought for 6m 29s(思考了 6 分 29 秒)。以下是 AEO 最近八个财季的门店 KPI,仅取自 American Eagle Outfitters 投资者关系(IR)材料。」
- 表格列:财季(Fiscal Qtr)|期末门店数(Stores, end of period)|总面积(Gross Sq Ft, 000s)|总可比销售(Total Comp Sales)|AE 品牌可比(AE Brand Comp)|Aerie 可比(Aerie Comp)
| 财季 | 门店数 | 面积(千平方英尺) | 总可比 | AE 可比 | Aerie 可比 |
|---|---|---|---|---|---|
| Q1 FY25 | 1,176 | 7,232 | -3% | -2% | -4% |
| Q4 FY24 | 1,172 ✗ | 7,304 | +3% | +1% | +6% |
| Q3 FY24 | 1,177 | 7,304 | +3% | +3% | +5% |
| Q2 FY24 | 1,178 | 7,350 | +4% | +5% | +4% |
| Q1 FY24 | 1,180 ✗ | 7,360 | +7% | +7% | +6% |
| Q4 FY23 | 1,182 ✗ | 7,391 | — | +6% | +13% |
(✗ 为课件上的红叉;单元格下方的来源小字多为「AEO Investor Relations」或「Q4 Capital」等,字很小【模糊】)
- 右侧结论:GPT-5 只思考了 6.5 分钟,就给出了 Q4'24、Q1'24、Q3'23 的错误门店数,还声称数据来源正确,出自 IR 材料(Correctly sources from IR materials)。
- 注:右侧文字写的是「Q3'23」,表中第三个红叉所在行标为「Q4 FY23」,原文照录,未作更正。
- 来源:Kris Bennatti + Internal【后半被裁切】
图表说明:ChatGPT 表格截图,三处门店数被打红叉。
要点:最危险的错误是「有来源标注的错数字」,看上去可信,实际上错了。
P12 大约十次对六次(Right About Six Times in Ten)
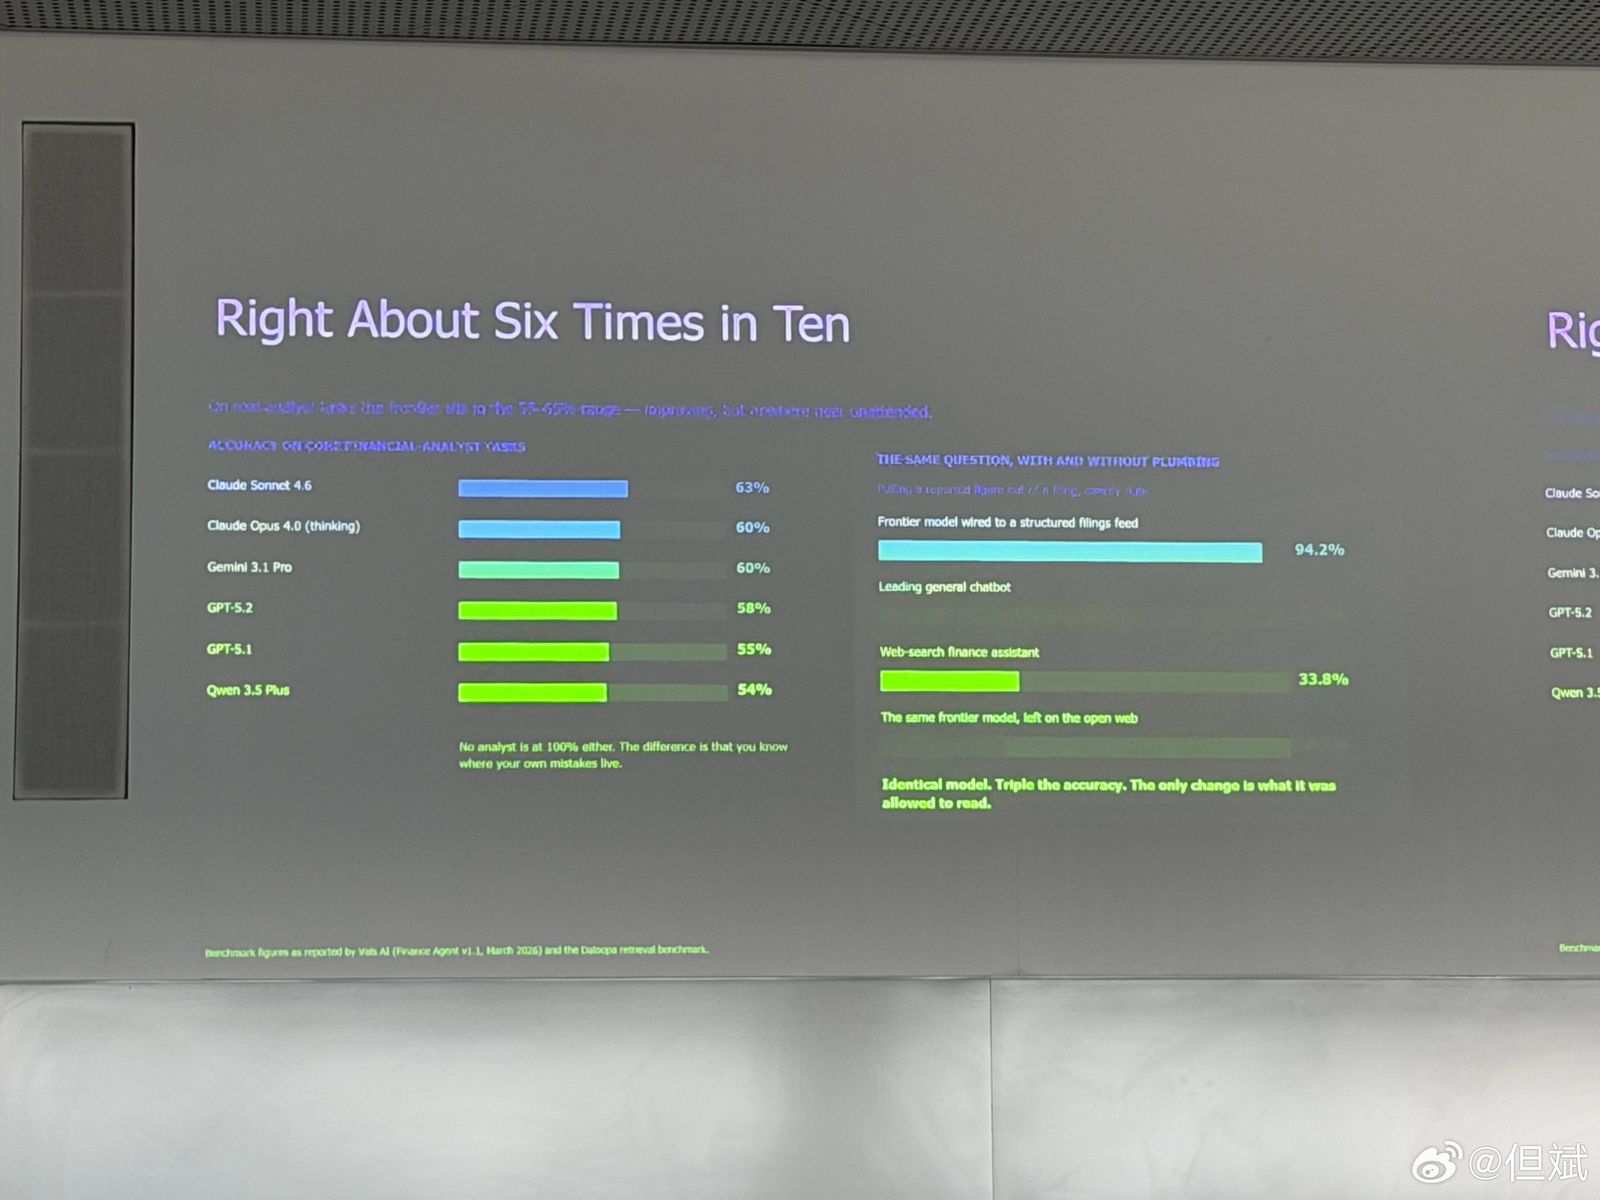
翻译:
- 副标题:【模糊】(大意似为「在核心分析师任务上,前沿模型处于约 5x–6x% 区间,令人印象深刻,但远不能无人值守」,具体数字和措辞看不清)
- 左图,核心金融分析任务准确率(Accuracy on core financial-analyst tasks):Claude Sonnet 4.6 为 63%;Claude Opus 4.0 (thinking) 为 60%;Gemini 3.1 Pro 为 60%;GPT-5.2 为 58%;GPT-5.1 为 55%;Qwen 3.5 Plus 为 54%。
- 图注:没有哪个分析师是 100% 正确的。区别在于,你知道自己的错误出在哪里。
- 右图,同一个问题,有无「管道」的差别(The same question, with and without plumbing):
- 小标题【模糊,疑为「从申报文件中准确提取一个已披露数字」】
- 前沿模型接入结构化申报文件数据源(Frontier model wired to a structured filings feed):94.2%
- 领先的通用聊天机器人(Leading general chatbot):数值【模糊,条形和数字都看不清】
- 网页搜索型金融助手(Web-search finance assistant):33.8%
- 同一个前沿模型,放在开放网络上(The same frontier model, left on the open web):数值【模糊】
- 结论:模型完全相同,准确率是三倍。唯一的变化是允许它读什么。
- 脚注:基准数据来自 Vals AI(Finance Agent v1.1,2026 年 3 月)及 Daloopa 检索基准(Daloopa retrieval benchmark)。
图表说明:两组水平条形图。左边是各模型得分,右边是数据接入方式对比。
要点:模型之间的差距只有几个百分点,数据管道带来的差距能到 3 倍。投资应该优先放在数据接入(plumbing)上。
P13 信念是拼装出来的,不是检索出来的(Conviction Is Assembled, Never Retrieved)
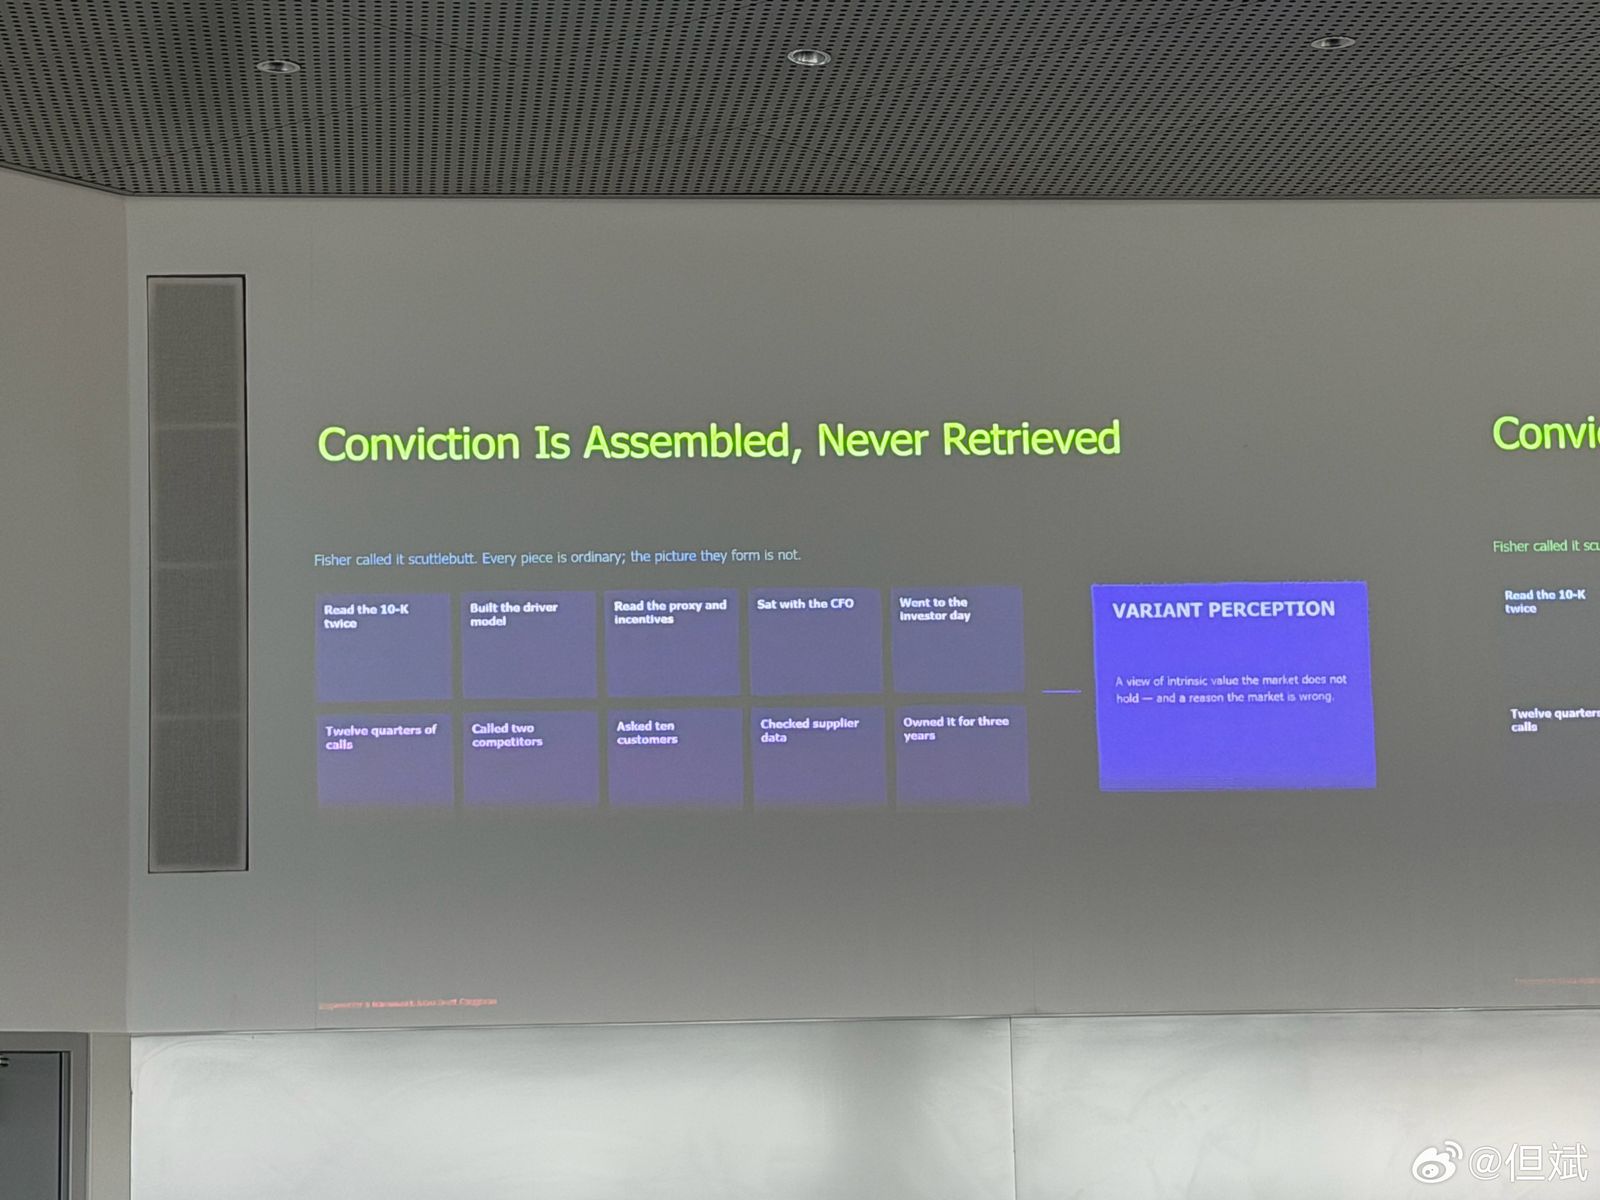
翻译:Fisher 把它叫作「闲聊调研法」(scuttlebutt)。每一块拼图都很普通,拼出来的整体却不普通。
- 十块拼图:把 10-K 读两遍(Read the 10-K twice)|搭建驱动因素模型(Built the driver model)|读委托书与激励方案(Read the proxy and incentives)|和 CFO 面谈(Sat with the CFO)|参加投资者日(Went to the investor day)|听了 12 个季度的电话会(Twelve quarters of calls)|给两家竞争对手打电话(Called two competitors)|问了十个客户(Asked ten customers)|核查供应商数据(Checked supplier data)|持有三年(Owned it for three years)
- 汇总结果:差异化认知(VARIANT PERCEPTION),即市场没有持有的内在价值观点,再加上市场为什么错了的理由。
- 左下角红色小字脚注【模糊】
图表说明:左边 2×5 方块阵列,用一条线连到右边的蓝色大方块。
要点:真正的 alpha 来自长期、多来源的一手调研拼起来的认知,问一次 AI 拿不到。(Fisher 应指 Philip Fisher,这是整理者注,课件只写 Fisher)
P14 「论点形状的物体」(The Thesis-Shaped Object)
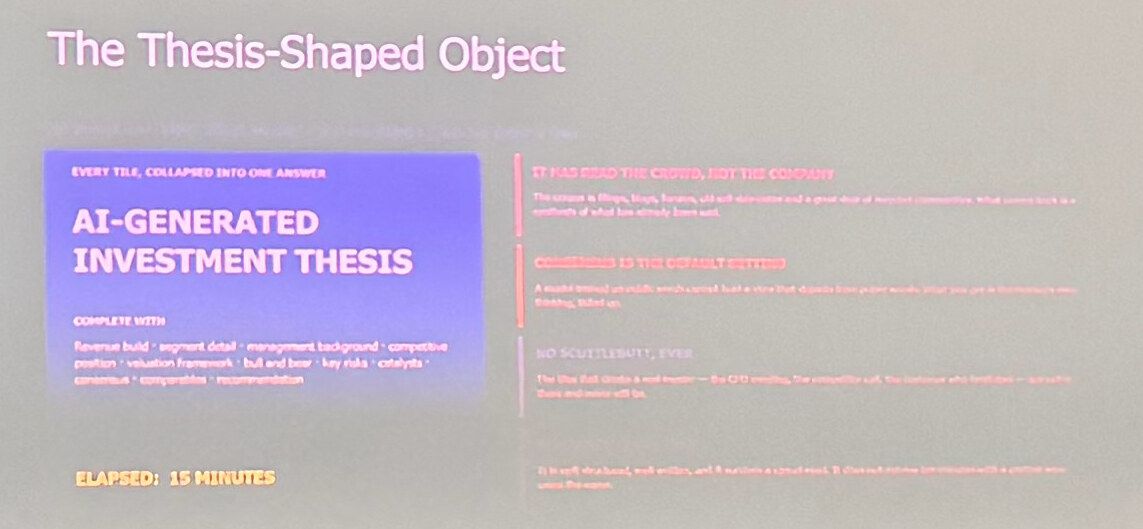
翻译:
- 副标题:【模糊】
- 左边大卡片:每块拼图都被压缩成一个答案(EVERY TILE, COLLAPSED INTO ONE ANSWER)→ AI 生成的投资论点(AI-GENERATED INVESTMENT THESIS)
- 内容齐全(COMPLETE WITH):收入拆分(Revenue build)· 分部细节(segment detail)· 管理层背景(management background)· 竞争地位(competitive position)· 估值框架(valuation framework)· 多空观点(bull and bear)· 主要风险(key risks)· 催化剂(catalysts)· 一致预期(consensus)· 可比公司(comparables)· 投资建议(recommendation)
- 耗时:15 分钟(ELAPSED: 15 MINUTES)
- 右边三条批评(标题可辨,正文【模糊】):
- 它读的是人群,不是公司(IT HAS READ THE CROWD, NOT THE COMPANY)。正文【模糊】,大意似为「语料来自申报文件、博客、论坛、卖方研究……得到的是已有观点的综合」
- 共识是默认设置(CONSENSUS IS THE DEFAULT SETTING)。正文【模糊】
- 从来没有实地调研(NO SCUTTLEBUTT, EVER)。正文【模糊】,可辨出「the CFO」「the competitor」「the customer」等词
- 底部一行结论【模糊】
图表说明:与 P13 对照。P13 是十块拼图拼出差异化认知,P14 是 AI 把所有拼图压成一份 15 分钟写完的「完整报告」。
要点:AI 报告形式齐全,但默认输出的是共识。形似论点不等于论点。
P15 对错误问题给出正确答案(The Right Answer to the Wrong Question)
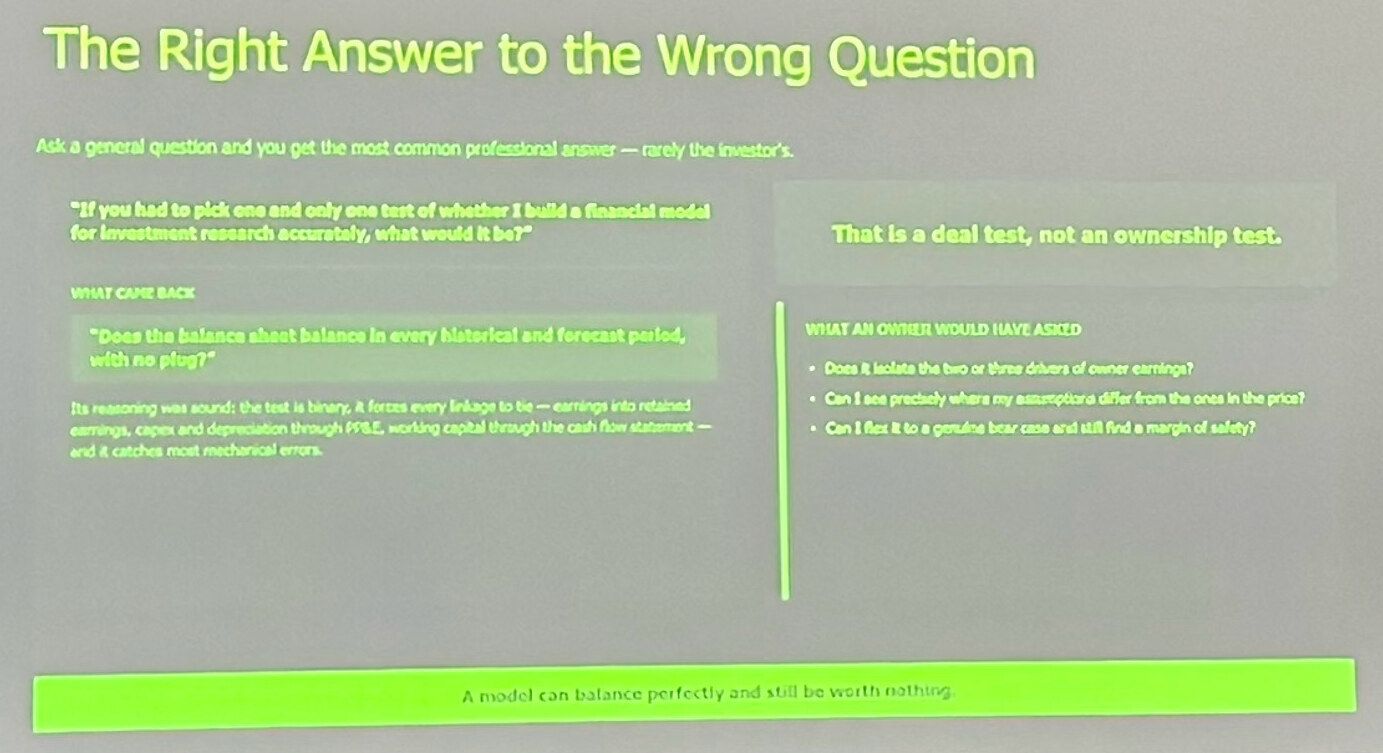
翻译:问一个泛泛的问题,你得到的是最常见的专业答案,很少是投资者需要的那个答案。
- 提问:「如果只能挑一个、且仅此一个检验,来判断我为投资研究搭的财务模型是否准确,那会是什么?」
- 得到的回答(WHAT CAME BACK):「资产负债表在每个历史期和预测期都能配平,而且不用插值项(no plug)吗?」
- 它的推理没问题:这个检验是二元的,强制每个勾稽关系都要对上,包括盈利转入留存收益、资本开支和折旧通过 PP&E、营运资本通过现金流量表,能抓住大多数机械性错误。
- 右侧:这是交易检验,不是所有权检验(That is a deal test, not an ownership test)。
- 一个所有者会问的(WHAT AN OWNER WOULD HAVE ASKED):
- 它是否分离出了所有者盈余(owner earnings)的两三个驱动因素?
- 我能否准确看出自己的假设和价格隐含的假设差在哪里?
- 我能否把它调到一个真正的熊市情形(bear case),仍然找得到安全边际(margin of safety)?
- 底部:一个模型可以完美配平,却仍然一文不值。
图表说明:左右两栏对比,底部是绿色结论条。
要点:AI 的答案质量受提问框架限制。要用「所有者视角」的问题去约束它,不能接受默认的行业标准答案。
P16 行业比价:从几小时到几秒(Industry Comps: From Hours to Seconds)
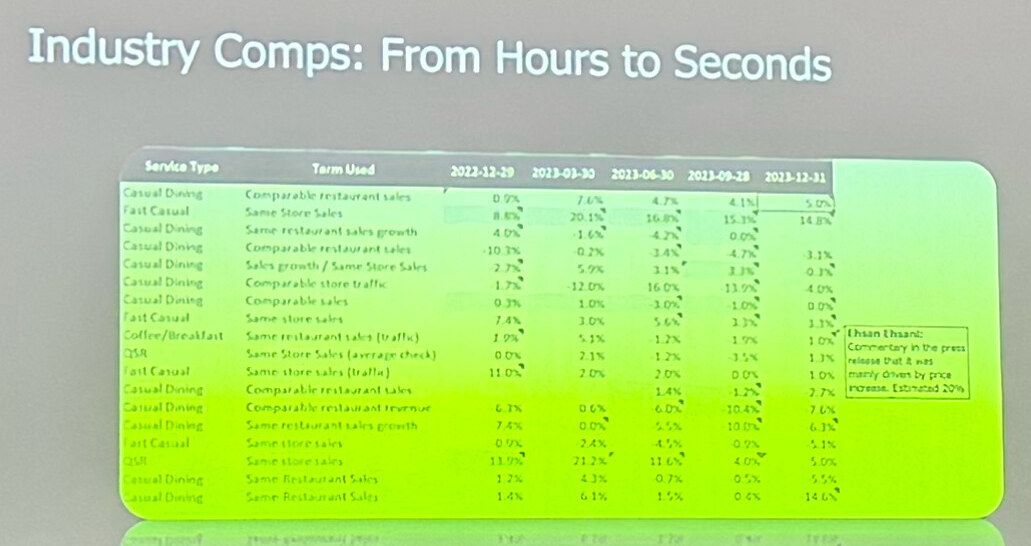
翻译:
- 表头:业态(Service Type)|所用术语(Term Used)|2022-12-29|2023-03-30|2023-06-30|2023-09-28|2023-12-31
- 共 18 行餐饮公司(公司名未显示),业态包括休闲餐饮(Casual Dining)、快休闲(Fast Casual)、咖啡/早餐(Coffee/Breakfast)、快餐(QSR)。「同店销售」的叫法各不相同:Comparable restaurant sales、Same Store Sales、Same restaurant sales growth、Sales growth / Same Store Sales、Comparable store traffic、Comparable sales、Same restaurant sales (traffic)、Same Store Sales (average check)、Same store sales (traffic)、Comparable restaurant revenue 等。
- 示例行(较清晰):
- Casual Dining · Comparable restaurant sales:0.9%,7.6%,4.7%,4.1%,5.0%
- Fast Casual · Same Store Sales:8.8%,20.1%,16.8%,15.1%,14.8%
- 其余数字在投影上大体可辨,但小数点和正负号容易看错,没有逐格转写,请对照原图。
- 右侧批注:「Ehsan Ehsani:新闻稿中的评论显示主要由提价驱动。估计 20%」(Commentary in the press release that it was mainly driven by price increase. Estimated 20%)
图表说明:荧光绿底的大表格,部分单元格带角标(应是来源或备注标记)。
要点:AI 适合把口径不统一的指标对齐、归类,这类工作能从几小时压到几秒。判断性的批注(比如提价贡献估计)仍由分析师来做。
第三部分 · 打造你的第一个价值投资智能体(帖三)
关于「三人团队管理一百亿」:这个说法只出自但斌帖三的标题(「AI 不是替代分析师,而是让三人团队跑出一百亿的资产」),课件里没有「一百亿」这个数字。P19 的课件表格写的是 Oakcliff Capital 3 人、$360M(3.6 亿美元),Peninsula Capital 3 人、$2.7B(27 亿美元),该页标注的来源是 Bryan Lawrence。
P17 第 0 步:先写手册(Step 0: Build The Playbook)|课件第 21 页
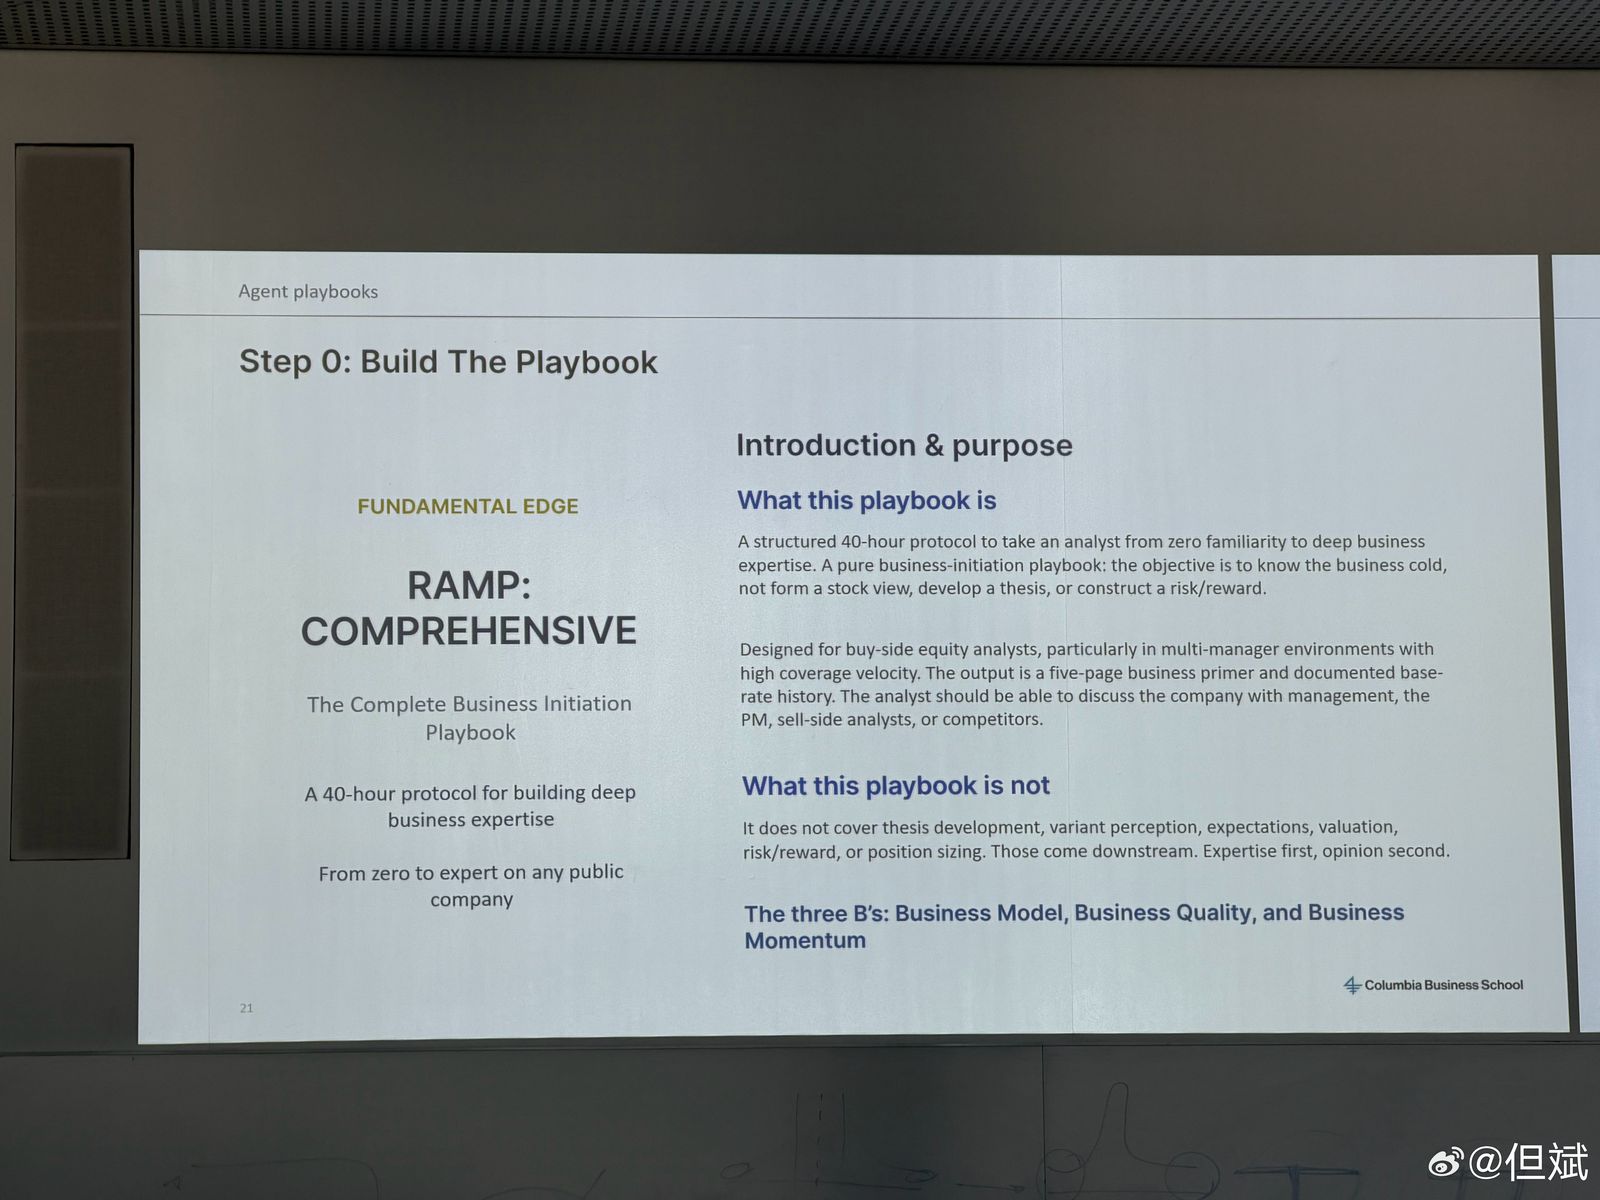
翻译:页眉:智能体手册(Agent playbooks)
- 左侧封面:FUNDAMENTAL EDGE|RAMP: COMPREHENSIVE|完整的公司入门手册(The Complete Business Initiation Playbook)|一套 40 小时的流程,用来建立对一家公司的深度业务认知|从零到精通任何一家上市公司
- 简介与目的(Introduction & purpose)
- 这份手册是什么:一套结构化的 40 小时流程,让分析师从完全不熟悉一家公司,到具备深度业务专长。它是纯粹的「业务入门」手册,目标是把公司业务吃透(know the business cold),不是形成股票观点、发展投资论点或构建风险收益比。
- 面向买方股票分析师,尤其是覆盖速度快的多基金经理(multi-manager)平台。产出是一份五页的业务入门报告(business primer)和一份有记录的基准率历史(base-rate history)。分析师读完应能和管理层、PM、卖方分析师或竞争对手讨论这家公司。
- 这份手册不是什么:不涉及投资论点、差异化认知(variant perception)、预期、估值、风险收益或仓位。这些在下游环节完成。先有专长,再有观点。
- 三个 B:商业模式(Business Model)、商业质量(Business Quality)、商业动能(Business Momentum)
图表说明:左边是手册封面,右边是文字说明。
要点:要先把人做研究的方法写成手册,agent 才有可执行的「方法论文件」。
P18 第 1 步:要有可重复的流程(Step 1: have a repeatable process)|第 29 页
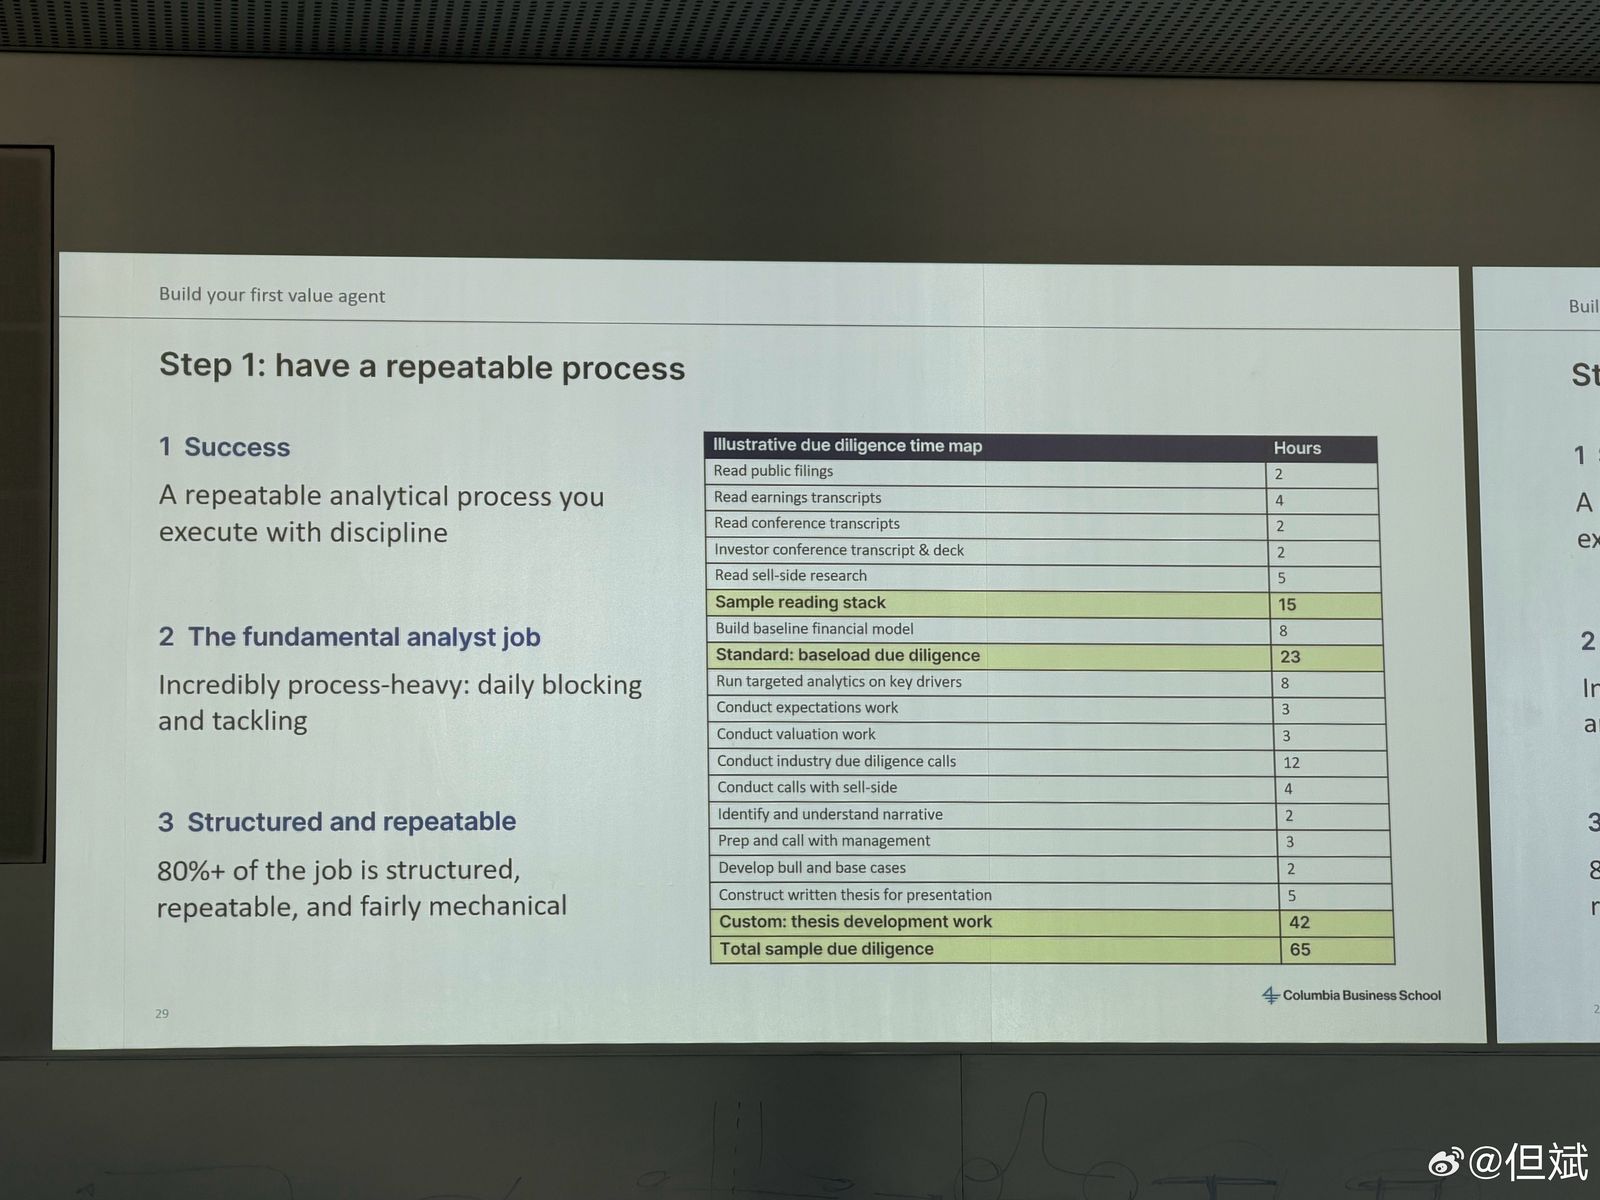
翻译:页眉:打造你的第一个价值投资智能体(Build your first value agent)
- 成功:一套你能有纪律地执行的、可重复的分析流程。
- 基本面分析师的工作:极其依赖流程,每天都是一件接一件地处理(daily blocking and tackling)。
- 结构化且可重复:这份工作 80% 以上是结构化、可重复、相当机械的。
示例:尽职调查时间分配表(Illustrative due diligence time map)
| 工作 | 小时 |
|---|---|
| 阅读公开申报文件(Read public filings) | 2 |
| 阅读财报电话会记录(Read earnings transcripts) | 4 |
| 阅读行业会议记录(Read conference transcripts) | 2 |
| 投资者会议记录与演示材料(Investor conference transcript & deck) | 2 |
| 阅读卖方研究(Read sell-side research) | 5 |
| 阅读包小计(Sample reading stack) | 15 |
| 搭建基础财务模型(Build baseline financial model) | 8 |
| 标准:基础尽调(Standard: baseload due diligence) | 23 |
| 对关键驱动因素做针对性分析(Run targeted analytics on key drivers) | 8 |
| 预期分析(Conduct expectations work) | 3 |
| 估值(Conduct valuation work) | 3 |
| 行业尽调访谈(Conduct industry due diligence calls) | 12 |
| 与卖方沟通(Conduct calls with sell-side) | 4 |
| 识别并理解市场叙事(Identify and understand narrative) | 2 |
| 准备并与管理层通话(Prep and call with management) | 3 |
| 形成多头与基准情形(Develop bull and base cases) | 2 |
| 撰写用于汇报的书面论点(Construct written thesis for presentation) | 5 |
| 定制:论点开发工作(Custom: thesis development work) | 42 |
| 尽调合计(Total sample due diligence) | 65 |
图表说明:时间表里黄绿色高亮的是小计行。
要点:65 小时里约 23 小时是「基础尽调」这类标准化工作,最适合先交给 agent。42 小时的定制论点工作仍以人为主。
P19 伟大的价值投资者一向用很小的团队管理很大的资本(Great value investors always ran big capital with tiny teams)|第 36 页
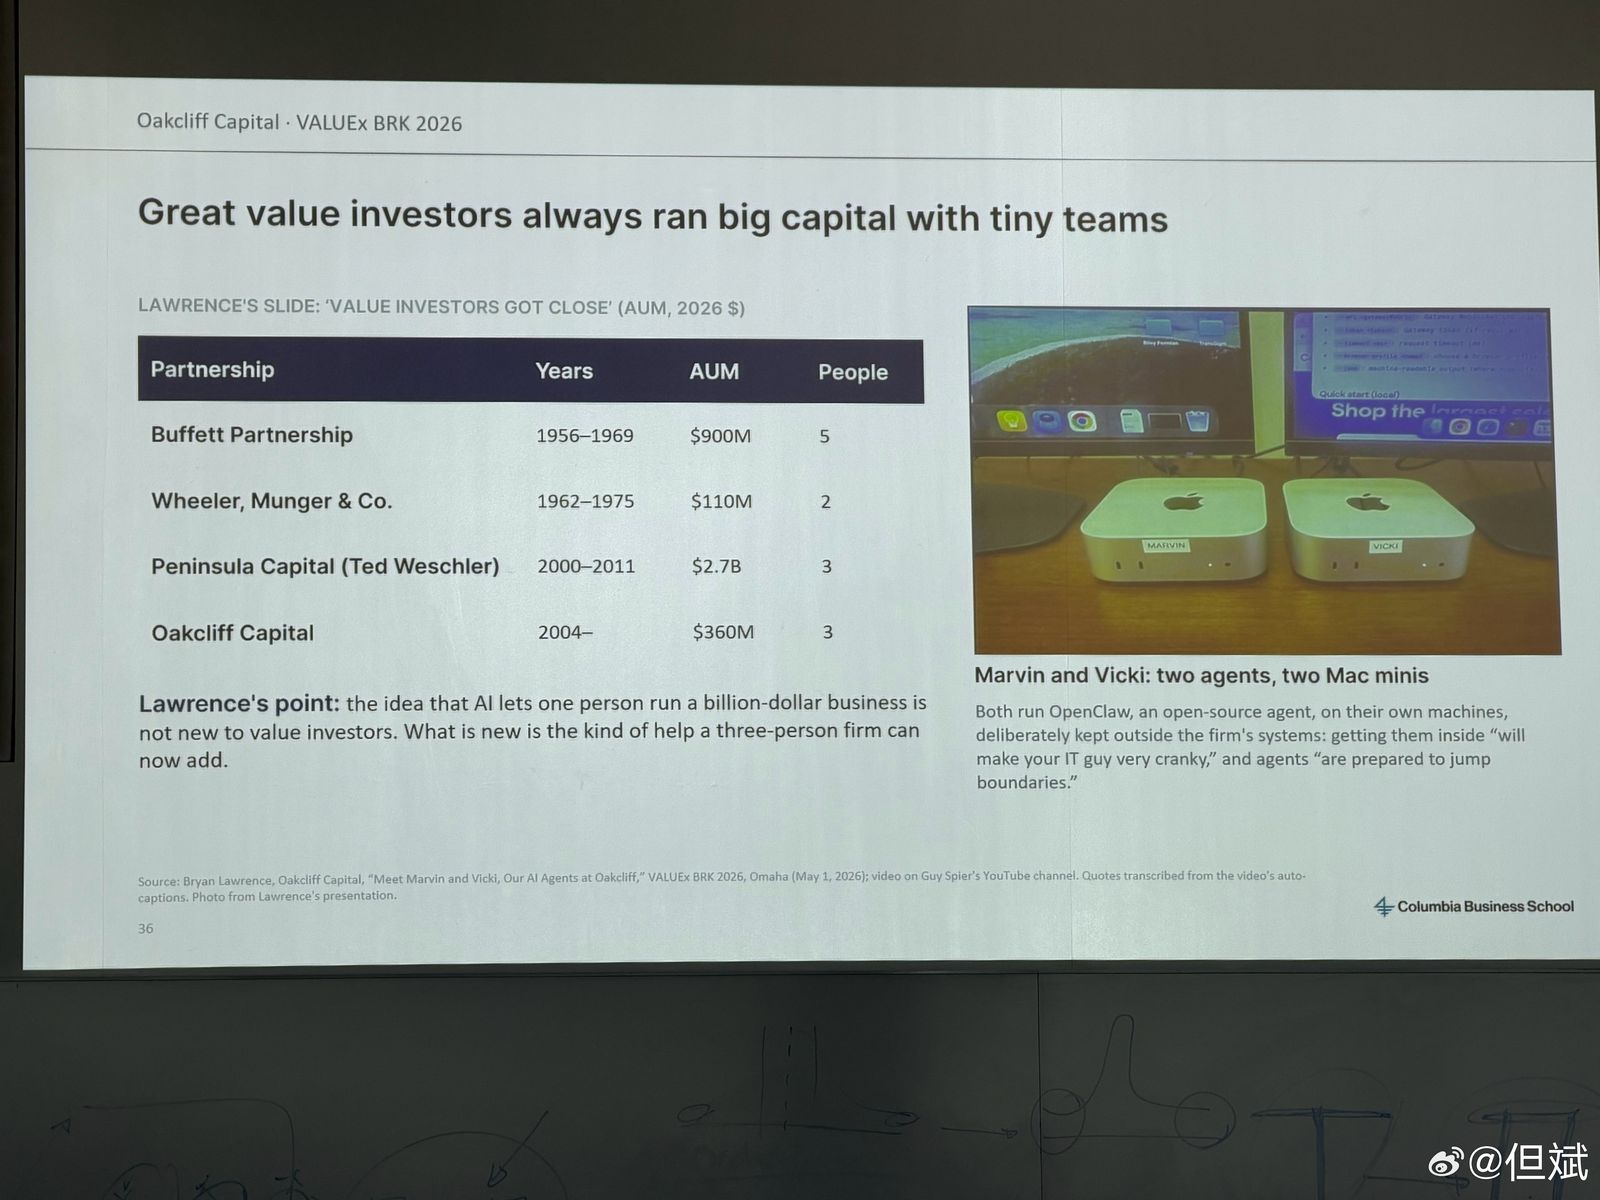
翻译:页眉:Oakcliff Capital · VALUEx BRK 2026
- 左表,Lawrence 的幻灯片「价值投资者早已做到」(‘VALUE INVESTORS GOT CLOSE’,AUM 以 2026 年美元计):
| 合伙企业 | 年份 | AUM | 人数 |
|---|---|---|---|
| 巴菲特合伙企业(Buffett Partnership) | 1956–1969 | $900M | 5 |
| Wheeler, Munger & Co. | 1962–1975 | $110M | 2 |
| Peninsula Capital(Ted Weschler) | 2000–2011 | $2.7B | 3 |
| Oakcliff Capital | 2004– | $360M | 3 |
- Lawrence 的观点:「AI 让一个人就能经营一家十亿美元的企业」,这个想法对价值投资者来说并不新鲜。新鲜的是,一家三人公司现在能获得的帮助是另一种了。
- 右图:Marvin 和 Vicki:两个智能体,两台 Mac mini。两者都运行开源智能体 OpenClaw,跑在各自独立的机器上,刻意放在公司系统之外。把它们接进公司系统「会让你的 IT 人员非常抓狂」,而且智能体「随时准备越界(are prepared to jump boundaries)」。
- 来源:Bryan Lawrence, Oakcliff Capital, “Meet Marvin and Vicki, Our AI Agents at Oakcliff,” VALUEx BRK 2026, Omaha (May 1, 2026);视频见 Guy Spier 的 YouTube 频道。引语据视频自动字幕转录,照片来自 Lawrence 的演讲。
图表说明:左边是表格,右边是两台贴着「MARVIN」「VICKI」标签的 Mac mini 照片。
要点:小团队管大资本是价值投资的老传统,AI 改变的是三人团队能得到的「助手」类型。安全上采取物理隔离。(「三人团队跑出一百亿」只是但斌帖三标题的说法。本页表格的原始数字是 Oakcliff 3 人、$360M,Peninsula 3 人、$2.7B,没有「一百亿」;本页注明来源为 Bryan Lawrence。)
P20 分层来看:模型是最不具专有性的一层(Read it in layers: the model is the least proprietary part)|第 39 页
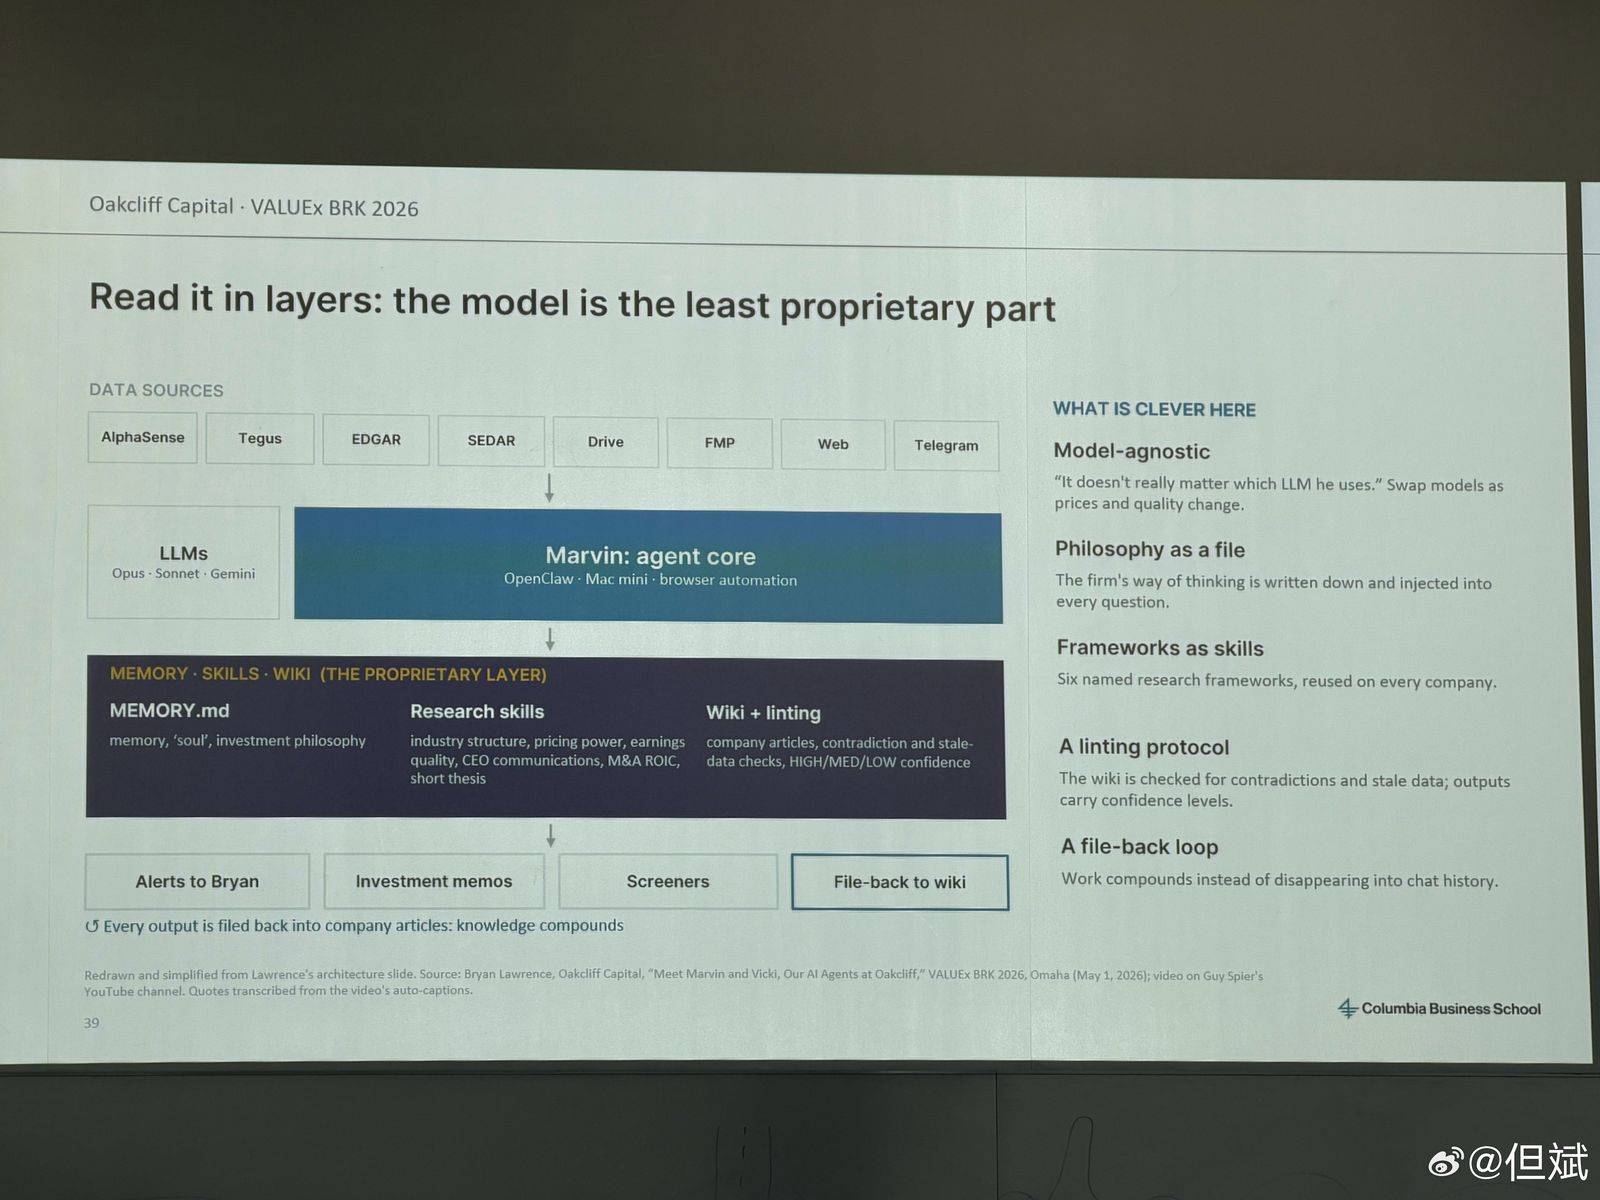
翻译:
- 数据源(DATA SOURCES):AlphaSense|Tegus|EDGAR|SEDAR|Drive|FMP|Web|Telegram
- LLMs:Opus · Sonnet · Gemini → Marvin:智能体核心(agent core),运行 OpenClaw · Mac mini · 浏览器自动化(browser automation)
- 记忆 · 技能 · Wiki(专有层,THE PROPRIETARY LAYER)
- MEMORY.md:记忆、「灵魂(soul)」、投资哲学
- 研究技能(Research skills):行业结构、定价权、盈利质量、CEO 沟通、并购 ROIC(M&A ROIC)、简版论点(short thesis)
- Wiki + 校验(linting):公司条目、矛盾与过期数据检查、高/中/低(HIGH/MED/LOW)置信度
- 输出:给 Bryan 的提醒(Alerts to Bryan)|投资备忘录(Investment memos)|筛选器(Screeners)|回写 wiki(File-back to wiki)
- ↺ 每次输出都回写进公司条目,让知识像复利一样积累(knowledge compounds)
- 右栏「巧妙之处(WHAT IS CLEVER HERE)」:
- 与模型无关(Model-agnostic):「他用哪个 LLM 其实无所谓。」随价格和质量变化切换模型。
- 哲学即文件(Philosophy as a file):公司的思考方式被写成文件,注入每一次提问。
- 框架即技能(Frameworks as skills):六个有名字的研究框架,每家公司都重复使用。
- 校验协议(A linting protocol):检查 wiki 里的矛盾和过期数据,输出带置信度。
- 回写闭环(A file-back loop):工作成果不断积累,而不是消失在聊天记录里。
- 来源:据 Lawrence 的架构图重绘简化,出处同 P19。
图表说明:四层架构图,从上到下依次是数据源、模型 + agent 核心、专有层、输出。
要点:护城河在专有层(框架、记忆、校验、回写),不在模型本身。
P21 聊天机器人从零开始,Marvin 从公司的记忆开始(A chatbot starts from zero; Marvin starts from the firm’s memory)|第 40 页(页码被裁切【模糊】,按前后页推断)
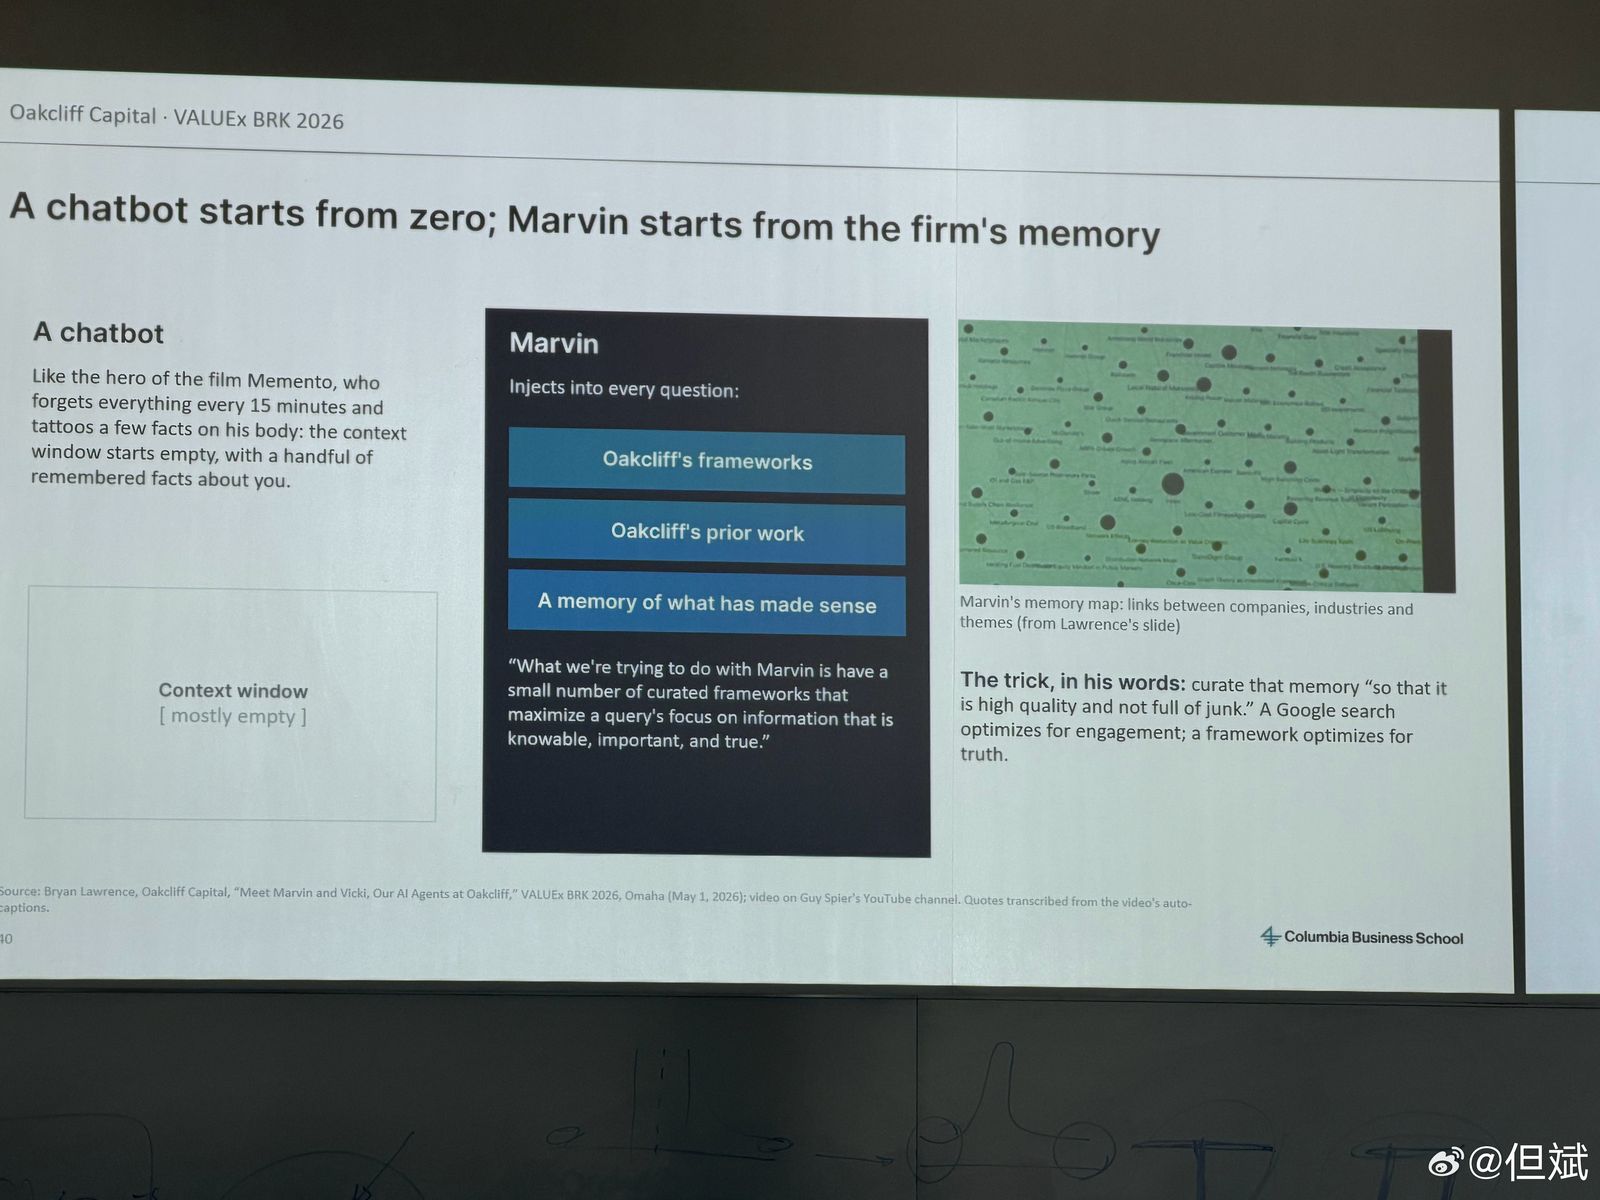
翻译:
- 聊天机器人:就像电影《记忆碎片》(Memento)的主角,每 15 分钟忘掉一切,只能把几条事实文在身上。上下文窗口一开始是空的,只记得关于你的少数几件事。(示意框:上下文窗口 [大部分是空的])
- Marvin 向每个问题注入三样东西:Oakcliff 的框架(Oakcliff’s frameworks)、Oakcliff 以往的工作(Oakcliff’s prior work)、一份「什么是合理的」记忆(A memory of what has made sense)。
- 「我们用 Marvin 想做的,是用少量精选的框架,让每次提问最大限度地聚焦在可知、重要且真实的信息上。」
- 右图:Marvin 的记忆图谱,显示公司、行业和主题之间的关联(取自 Lawrence 的幻灯片;图中节点小字【模糊】)。
- 用他的话说,诀窍是:精心维护这份记忆,「让它高质量,而不是塞满垃圾」。Google 搜索优化的是参与度,框架优化的是真相。
- 来源:同 P19。
图表说明:三栏,依次是空上下文窗口示意、Marvin 注入内容、绿色记忆网络图。
要点:AI 研究助手的价值取决于喂给它的机构记忆的质量。
P22 最值得优先搭建的五个智能体(按顺序)(The five agents worth building first, in order)|第 45 页
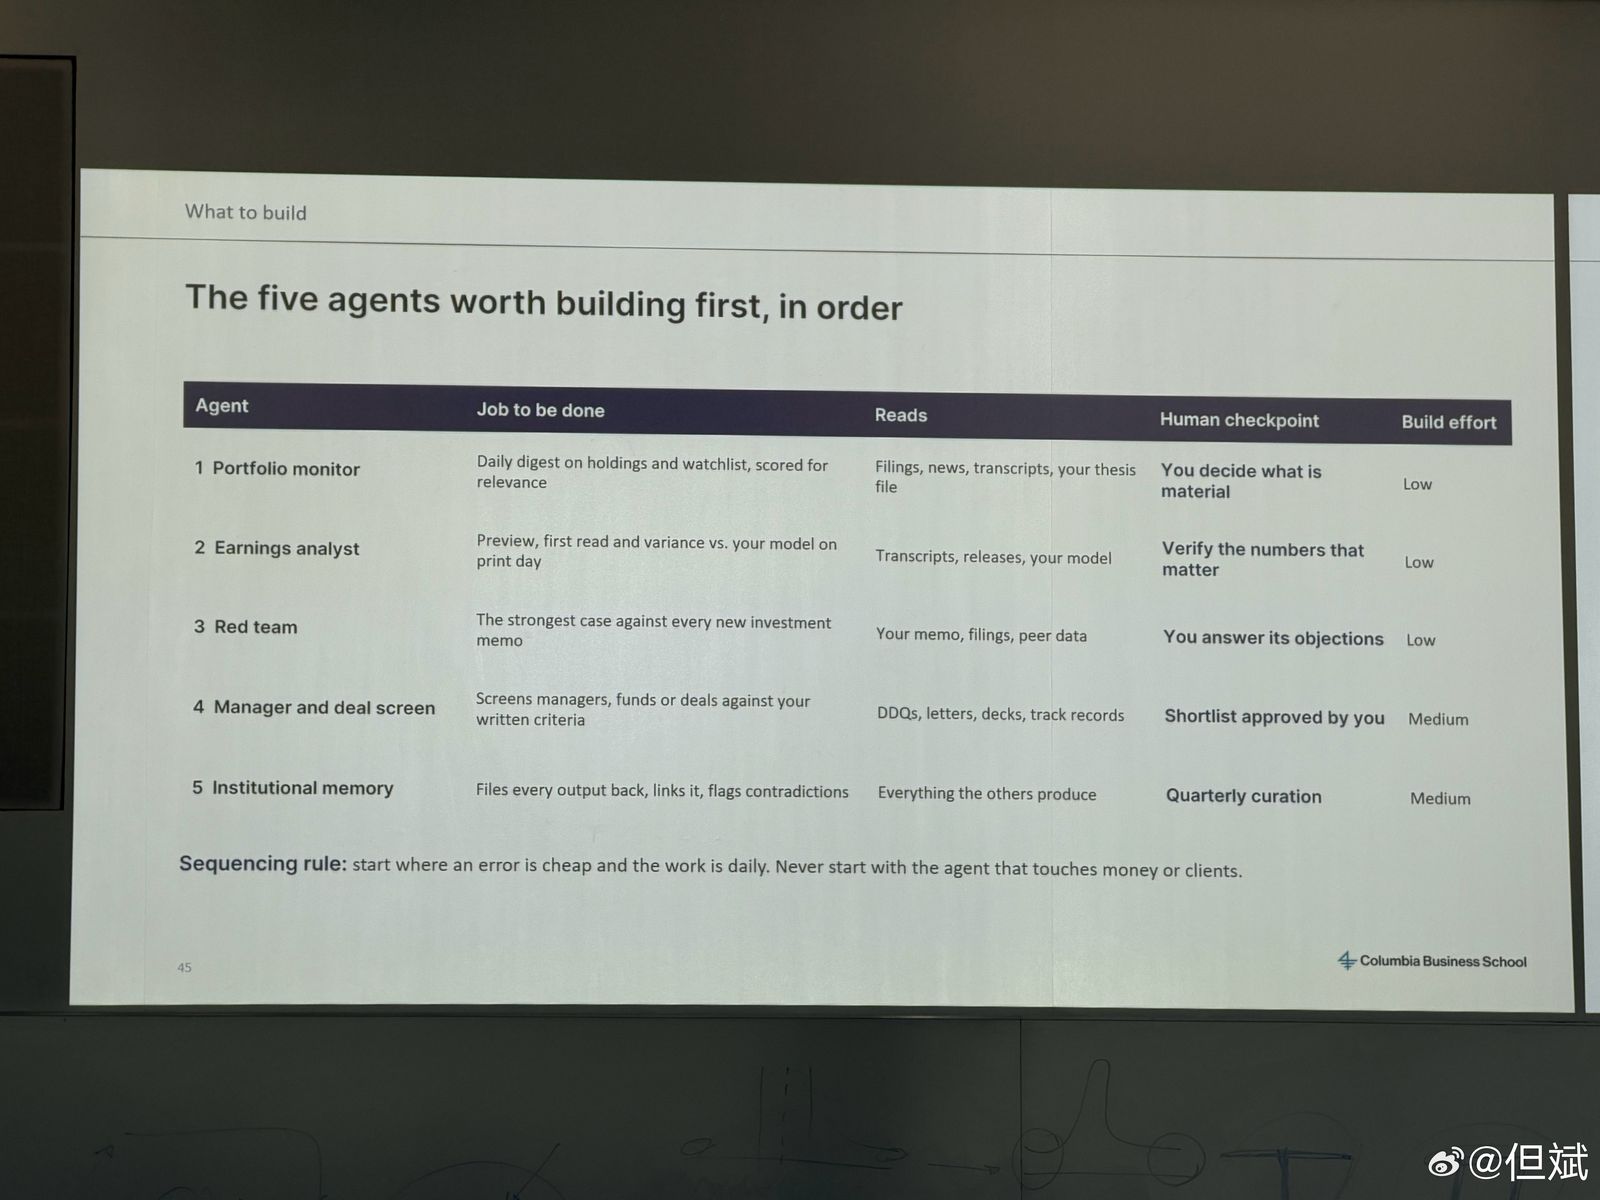
翻译:页眉:建什么(What to build)
| 智能体 | 要完成的工作 | 读取内容 | 人工检查点 | 搭建难度 |
|---|---|---|---|---|
| 1 组合监控(Portfolio monitor) | 每日汇总持仓和观察名单的动态,并按相关性打分 | 申报文件、新闻、电话会记录、你的论点文件 | 由你决定什么是重要的 | 低 |
| 2 财报分析师(Earnings analyst) | 财报日的预览、初读,以及与你模型的差异 | 电话会记录、公告、你的模型 | 核实关键数字 | 低 |
| 3 红队(Red team) | 针对每份新投资备忘录给出最强的反方论证 | 你的备忘录、申报文件、同业数据 | 你来回应它的质疑 | 低 |
| 4 管理人与交易筛选(Manager and deal screen) | 按你的书面标准筛选管理人、基金或交易 | DDQ、信件、路演材料、业绩记录 | 由你批准短名单 | 中 |
| 5 机构记忆(Institutional memory) | 回存每份输出、建立链接、标记矛盾 | 其他 agent 产出的一切 | 每季度整理 | 中 |
排序规则:从出错代价低、且每天都要做的工作开始。永远不要从涉及资金或客户的 agent 开始。
图表说明:五行表格。
要点:前三个难度都低、检查点清楚,适合作为团队试点。
P23 练习:为你的公司设计第一个智能体(Exercise: design the first agent for your firm)|第 54 页
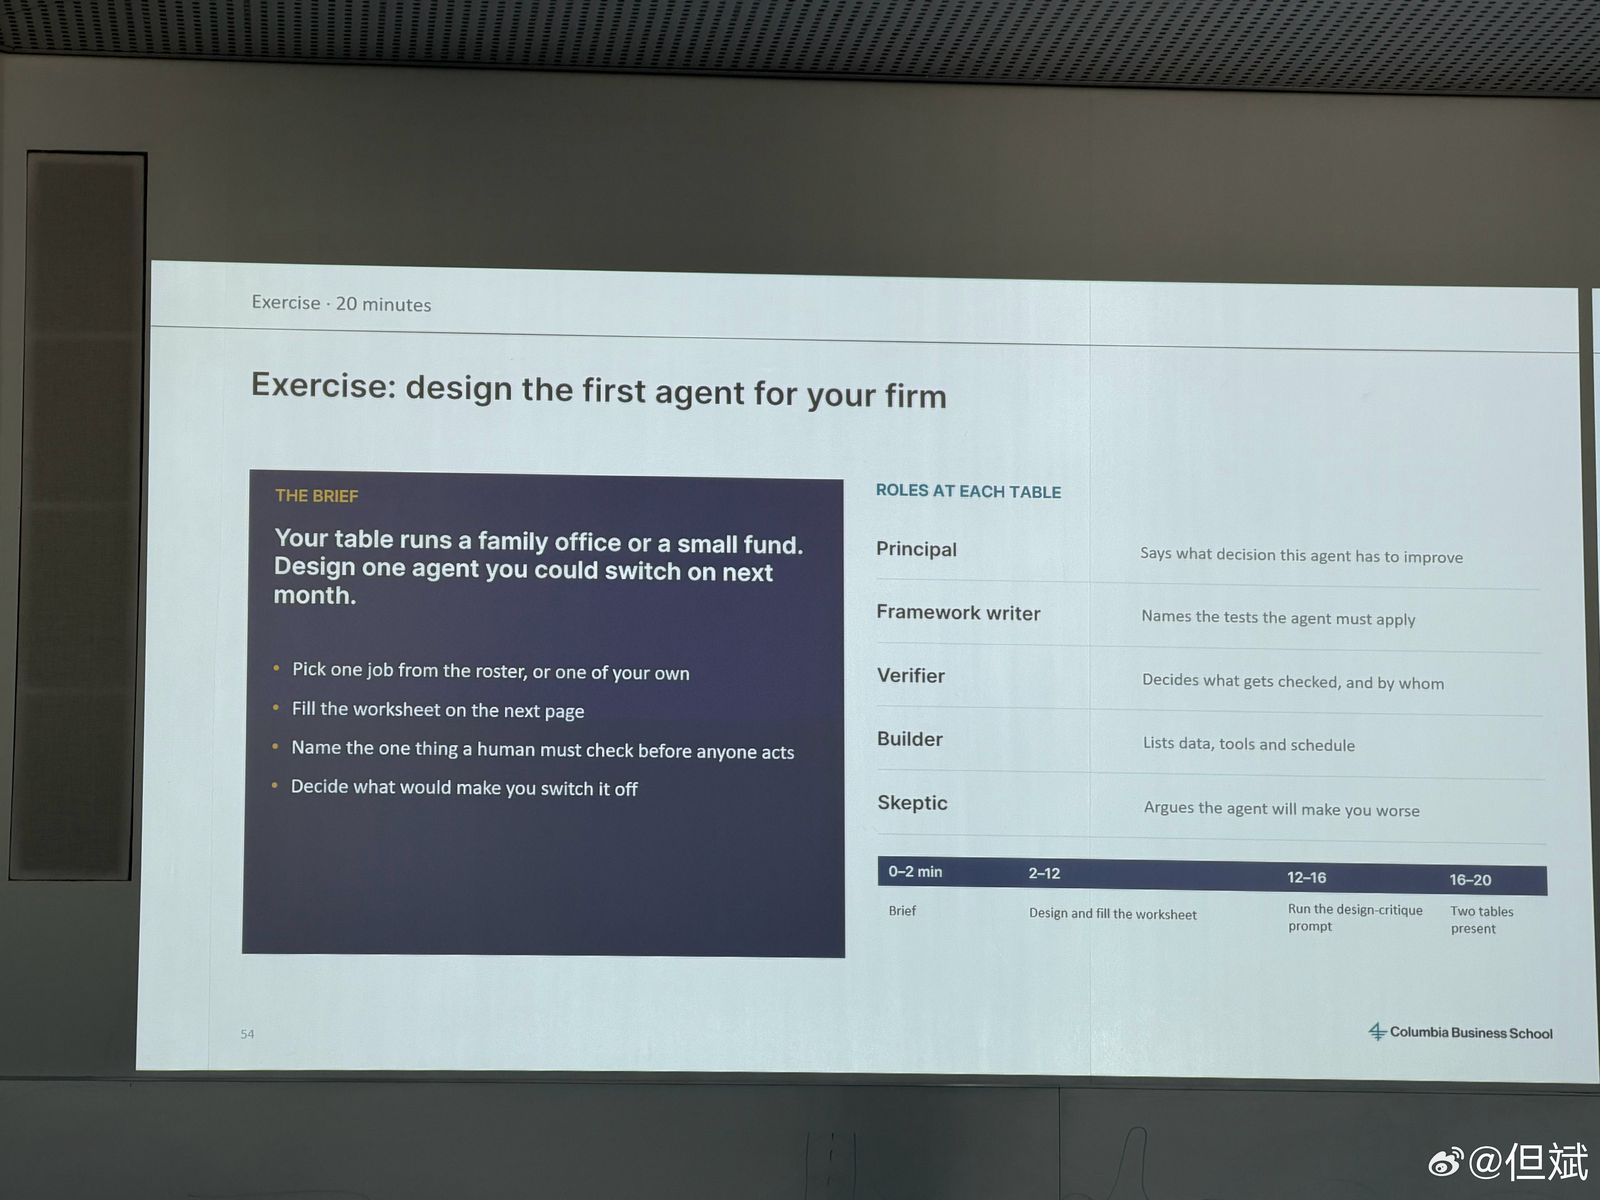
翻译:页眉:练习 · 20 分钟
- 任务(THE BRIEF):你这一桌经营一家家族办公室或小型基金。设计一个下个月就能启用的智能体。
- 从上一页的清单里挑一项工作,或者自己定一项
- 填写下一页的工作表
- 写明在任何人行动之前,必须由人检查的那一件事
- 想清楚在什么情况下你会把它关掉
- 每桌角色(ROLES AT EACH TABLE):
- 委托人(Principal):说明这个 agent 要改进哪个决策
- 框架撰写人(Framework writer):列出 agent 必须执行的检验
- 核查人(Verifier):决定检查什么、由谁检查
- 构建者(Builder):列出数据、工具和运行时间表
- 怀疑者(Skeptic):论证这个 agent 会让你变得更糟
- 时间安排:0–2 分钟讲解任务;2–12 分钟设计并填表;12–16 分钟运行设计评审提示词(design-critique prompt);16–20 分钟两桌展示。
图表说明:左边是紫色任务卡,右边是角色表和时间轴。
要点:专门设一个「怀疑者」角色,从设计阶段就把反方意见制度化。
P24 智能体设计表:九行,最后三行最难(Agent design sheet: nine lines, and the last three are the hard ones)|第 55 页
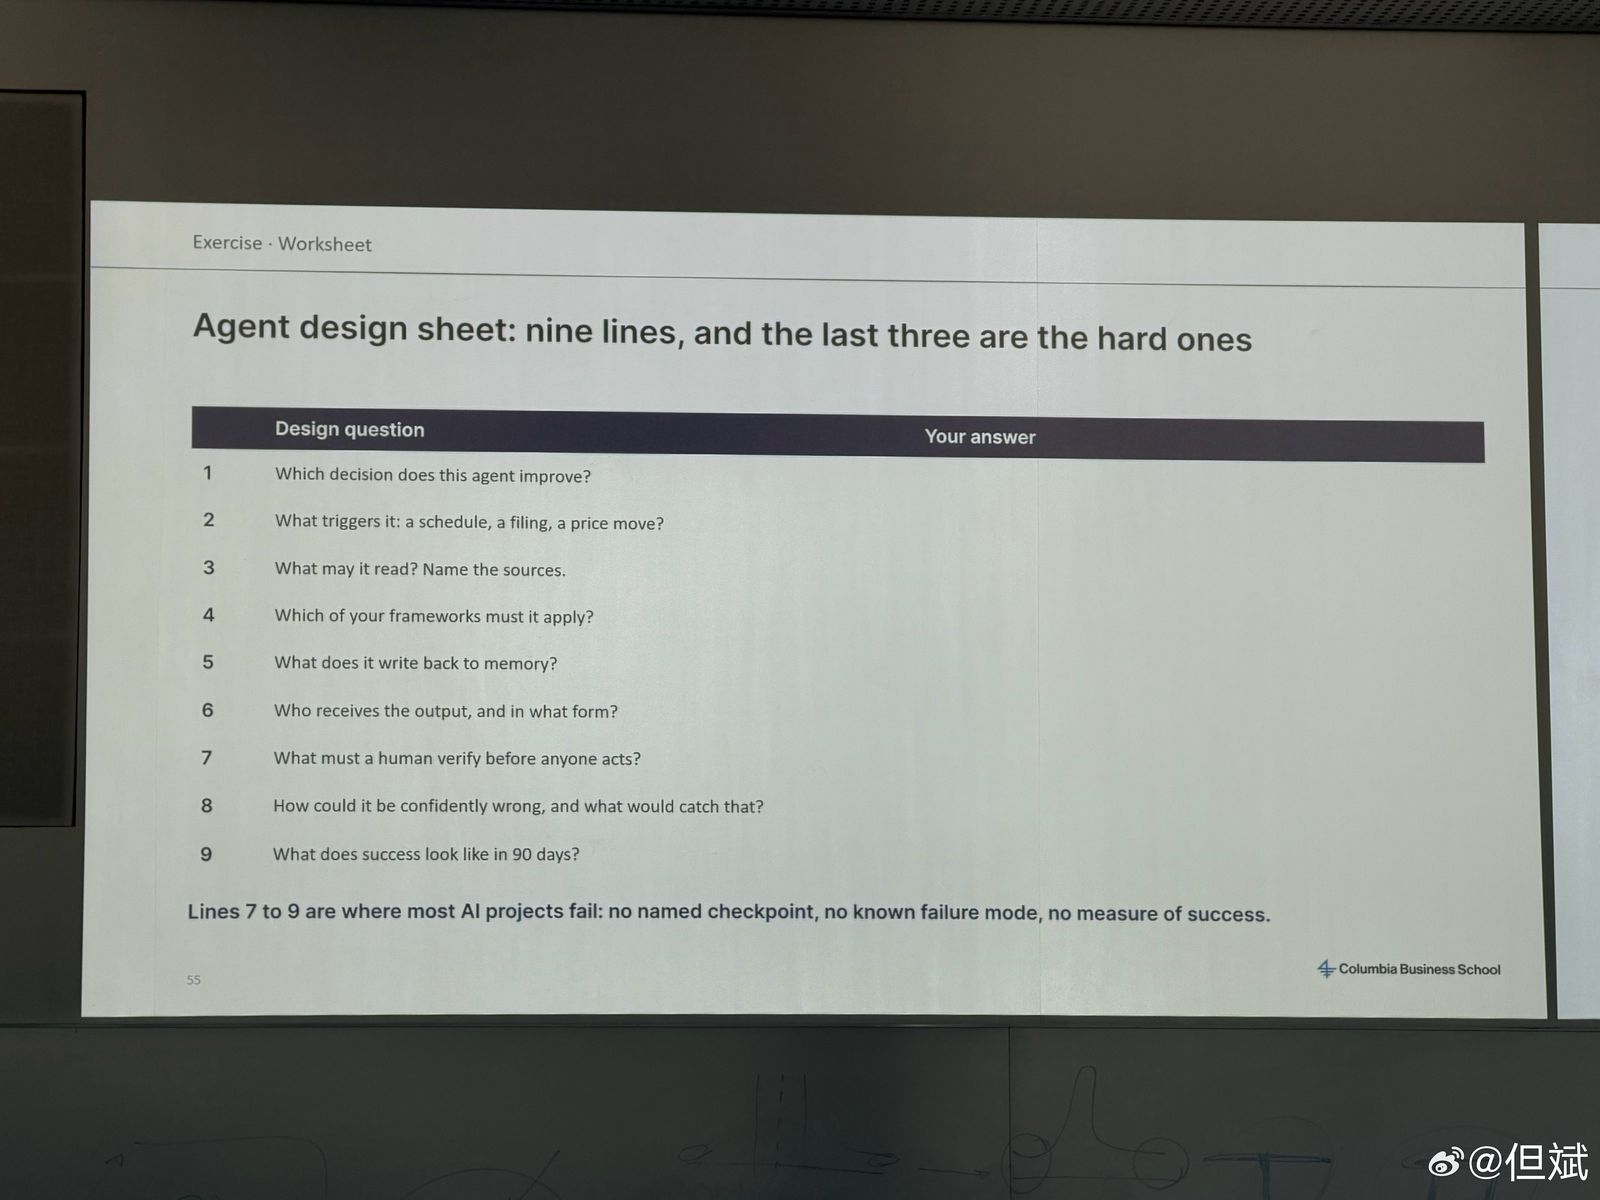
翻译(设计问题 / 你的答案):
- 这个 agent 改进的是哪个决策?
- 它由什么触发:定时、一份申报文件,还是一次价格变动?
- 它可以读什么?列出数据源。
- 它必须应用你的哪些框架?
- 它往记忆里回写什么?
- 谁接收输出,以什么形式?
- 在任何人行动之前,必须由人核实什么?
- 它可能怎样「自信地出错」?什么能发现这种错误?
- 90 天后,成功是什么样子?
第 7 到 9 行是大多数 AI 项目失败的地方:没有指定的检查点,不了解失效模式,没有成功的衡量标准。
图表说明:九行问答表,「你的答案」一栏留空。
要点:可以直接拿来做团队内部 AI 项目的立项模板。
第四部分 · 四重复合指数增长:AI 的底层驱动(帖四,06:54 长文配图)【存疑】
存疑:这部分讲算力、数据、模型、云的指数增长(曲线推演到 2036 年),很可能来自另一堂课(推测为 Hod Lipson 的讲座),不是 Ehsani 这堂课。课件为中英双语,版式与前三部分不同,画面中的讲者也与主讲人不同;但斌原帖把它归在 Ehsani 课程名下,这里按原帖收录。
P25 四种复合式指数增长现象(总览拼图,非原课件页)
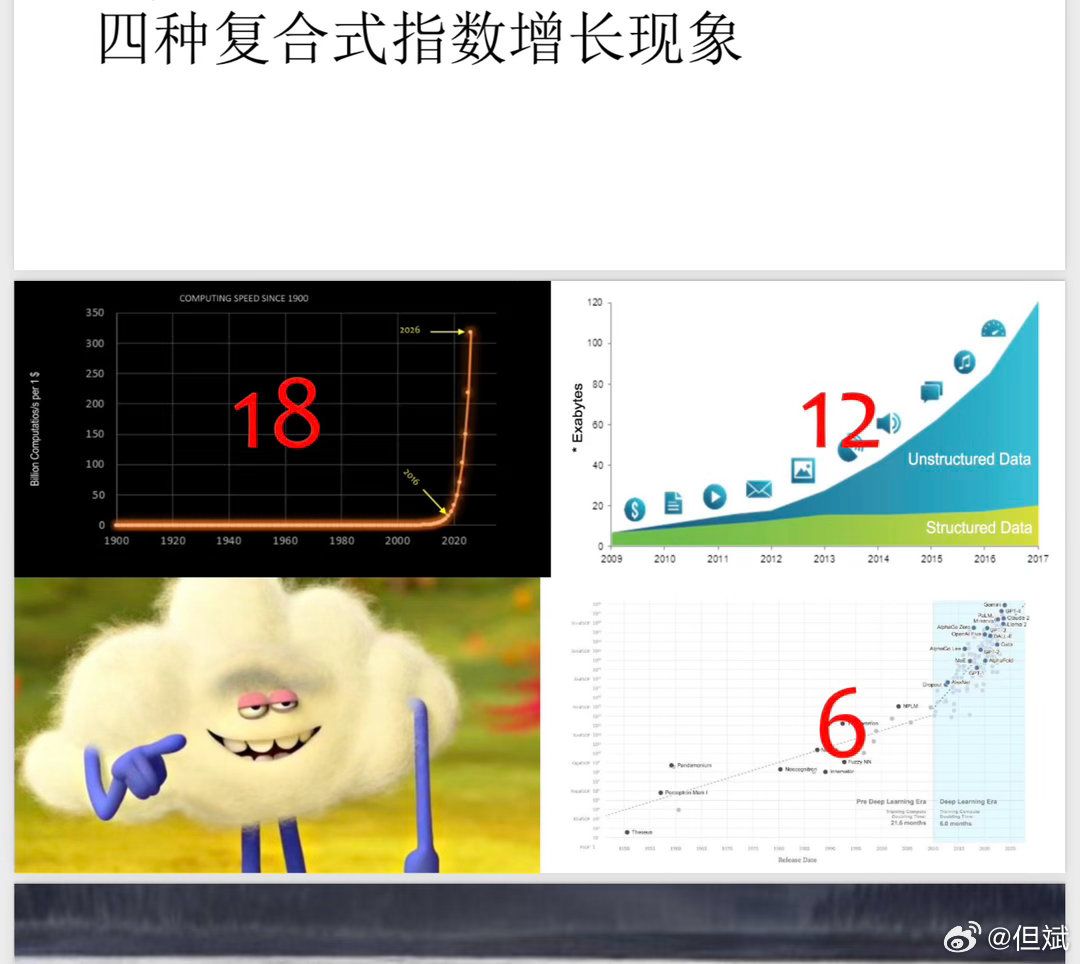
内容:但斌把四张图拼在一起,并用红色数字标出翻倍周期:
- 左上:自 1900 年以来的计算速度(每美元可买到的十亿次计算/秒),标「18」(个月)
- 右上:数据量(艾字节 Exabytes,2009–2017,分为非结构化数据 Unstructured Data 和结构化数据 Structured Data),标「12」(个月)
- 左下:卡通云朵形象(喻指云 / 云基础设施),无数字
- 右下:AI 训练算力散点图(Pre Deep Learning Era / Deep Learning Era),标「6」(个月)
要点:算力、数据、模型、云四重指数叠加,和长文「四重指数增长叠加,共同构成 AI 革命的底层驱动力」对应。
P26 自 1900 年以来的计算速度(至 2026 年)(Computing Speed Since 1900)
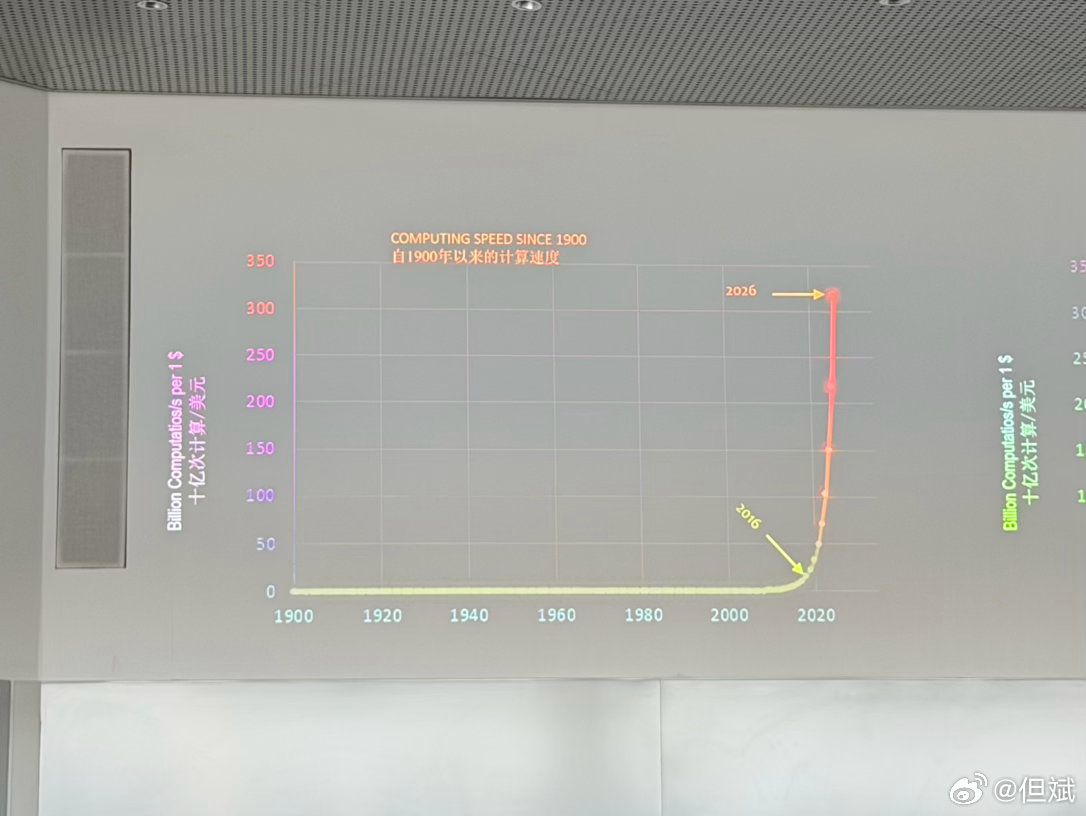
翻译:纵轴:每 1 美元可获得的十亿次计算/秒(Billion Computations/s per 1 $),0–350;横轴:1900–2020+。标注「2016」(曲线开始抬头)和「2026」(约 320,曲线顶点)。
图表说明:线性坐标。一百多年几乎贴着零走,2016 年后近乎垂直上升。
要点:在线性坐标下,指数增长前面很长一段看起来「什么都没发生」。
P27 自 1900 年以来的计算速度(推演至 2036 年)
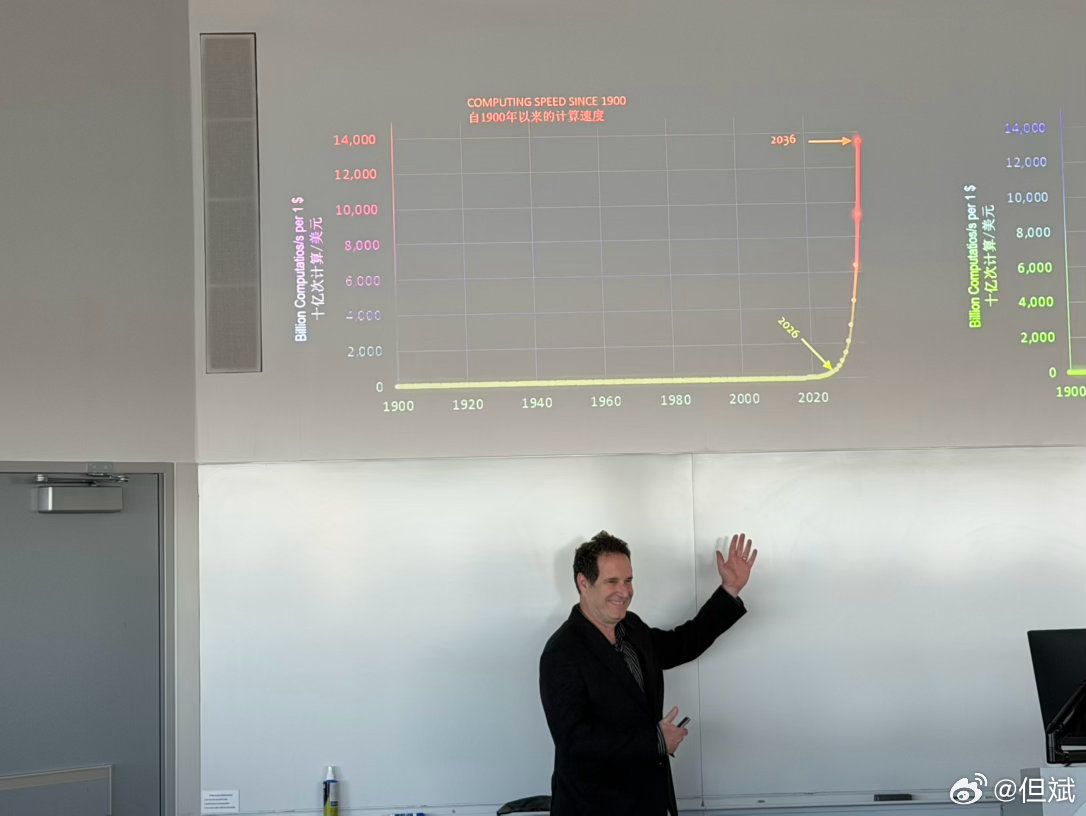
翻译:同一指标,纵轴扩到 0–14,000。标注「2026」(此时曲线看起来又贴着底部)和「2036」(约 14,000)。
图表说明:讲者站在屏幕下方用手示意曲线的陡峭程度。这张图带现场人物,但课件内容完整,予以收录。
要点:把时间轴延长十年,「今天的陡峭」又会变成「明天的平坦」。
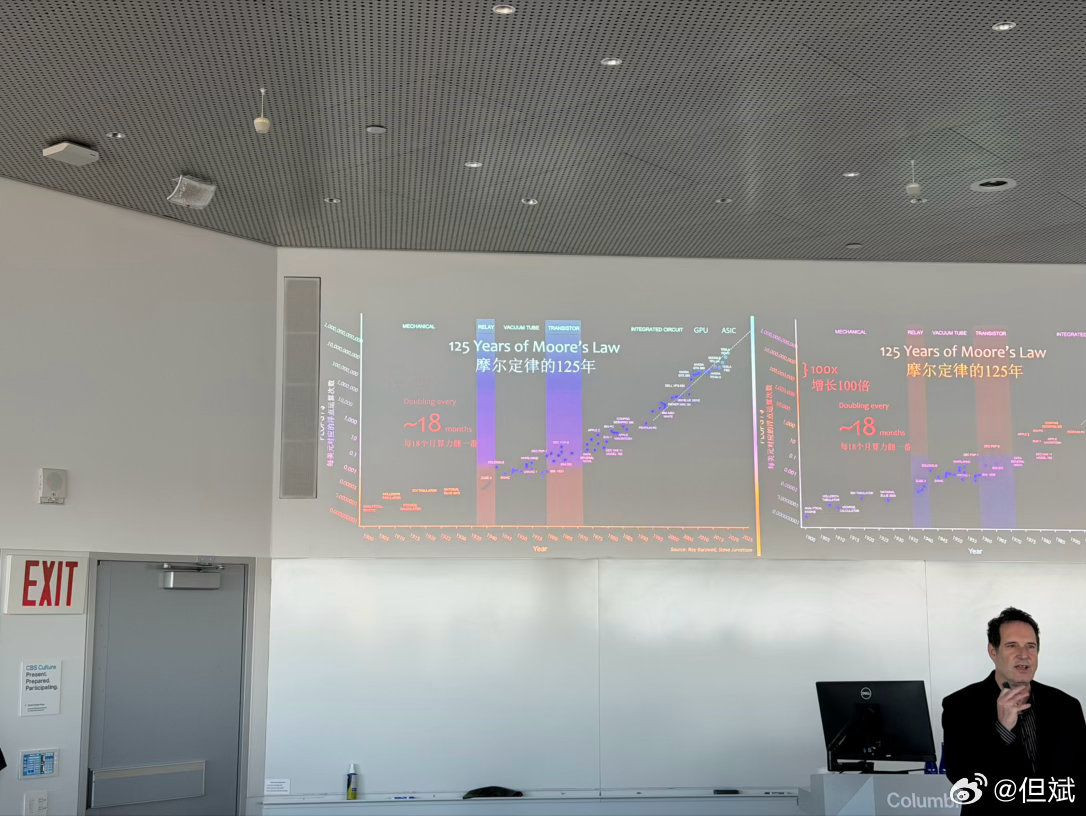
P28 摩尔定律的 125 年(125 Years of Moore’s Law)
(远距离现场照,分辨率低)
翻译:标题:125 Years of Moore’s Law / 摩尔定律的 125 年。
- 技术阶段(自左至右):机械(MECHANICAL)→ 继电器(RELAY)→ 真空管(VACUUM TUBE)→ 晶体管(TRANSISTOR)→ 集成电路(INTEGRATED CIRCUIT)→ GPU → ASIC
- 左侧标注:大约每 18 个月翻一番(Doubling every ~18 months)
- 右屏另有标注「100X / 增长 100 倍」
- 纵轴是对数刻度(每美元每秒计算次数【模糊】),横轴是年份(Year);数据点上的机型名称【模糊】;右下角来源【模糊,疑为 Ray Kurzweil】
图表说明:对数坐标散点图,各计算技术时代用色带区分。
要点:每次底层技术换代,摩尔定律式的增长都能延续,一共持续了 125 年。
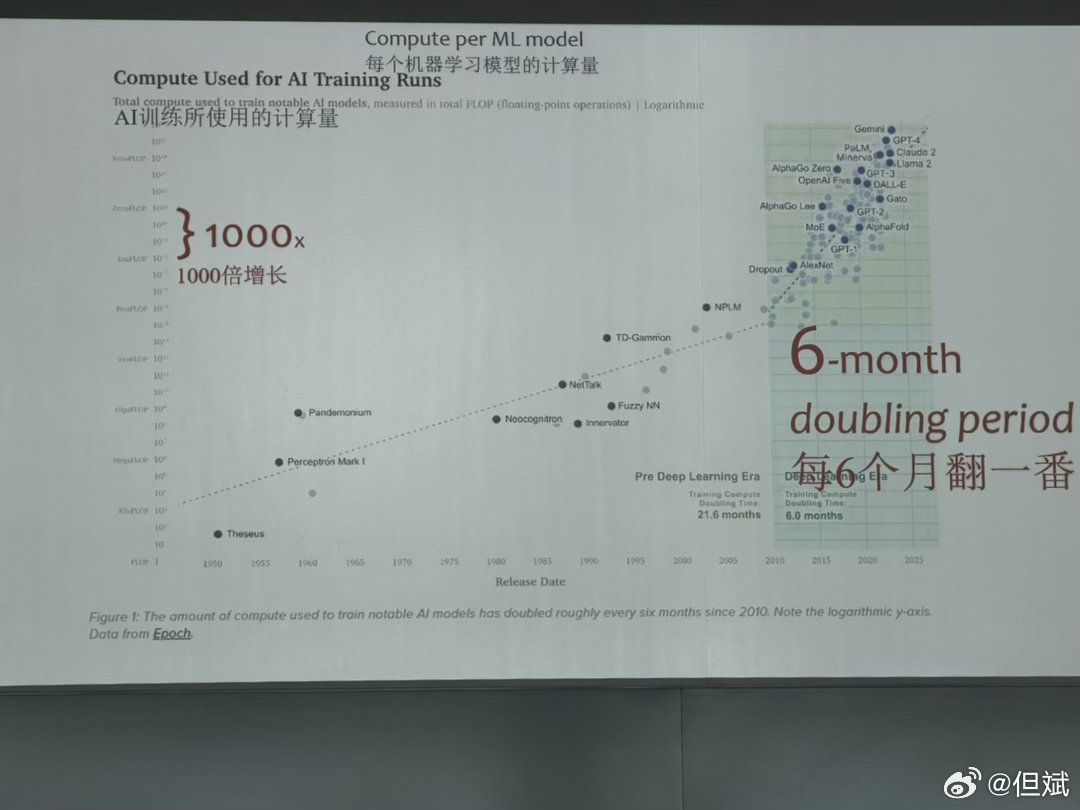
P29 每个机器学习模型的计算量(Compute per ML model / Compute Used for AI Training Runs)
翻译:
- 标题:Compute per ML model(每个机器学习模型的计算量);图题:Compute Used for AI Training Runs(AI 训练所用的计算量)
- 副标题:训练知名 AI 模型所用的总计算量,以总 FLOP(浮点运算次数)计 | 对数坐标
- 叠加标注:「}1000x / 1000 倍增长」;「6-month doubling period / 每 6 个月翻一番」
- 两个时代:深度学习之前(Pre Deep Learning Era),训练算力翻倍时间 21.6 个月;深度学习时代(Deep Learning Era),6.0 个月(这一组字被叠加标注部分遮挡)
- 散点代表模型:Theseus、Perceptron Mark I、Pandemonium、Neocognitron、NetTalk、TD-Gammon、Fuzzy NN、Innervator、NPLM、Dropout、AlexNet、MoE、AlphaGo Lee、AlphaGo Zero、OpenAI Five、PaLM、Minerva、GPT-1/2/3/4、DALL-E、Gato、AlphaFold、Gemini、Claude 2、Llama 2
- 图注:「图 1:自 2010 年以来,训练知名 AI 模型所用的计算量大约每六个月翻一番。注意纵轴是对数坐标。数据来自 Epoch。」
- 纵轴刻度小字(FLOP、KiloFLOP……)【模糊】
要点:深度学习时代的训练算力翻倍速度大约是摩尔定律的 3 倍(6 个月对 18 个月)。
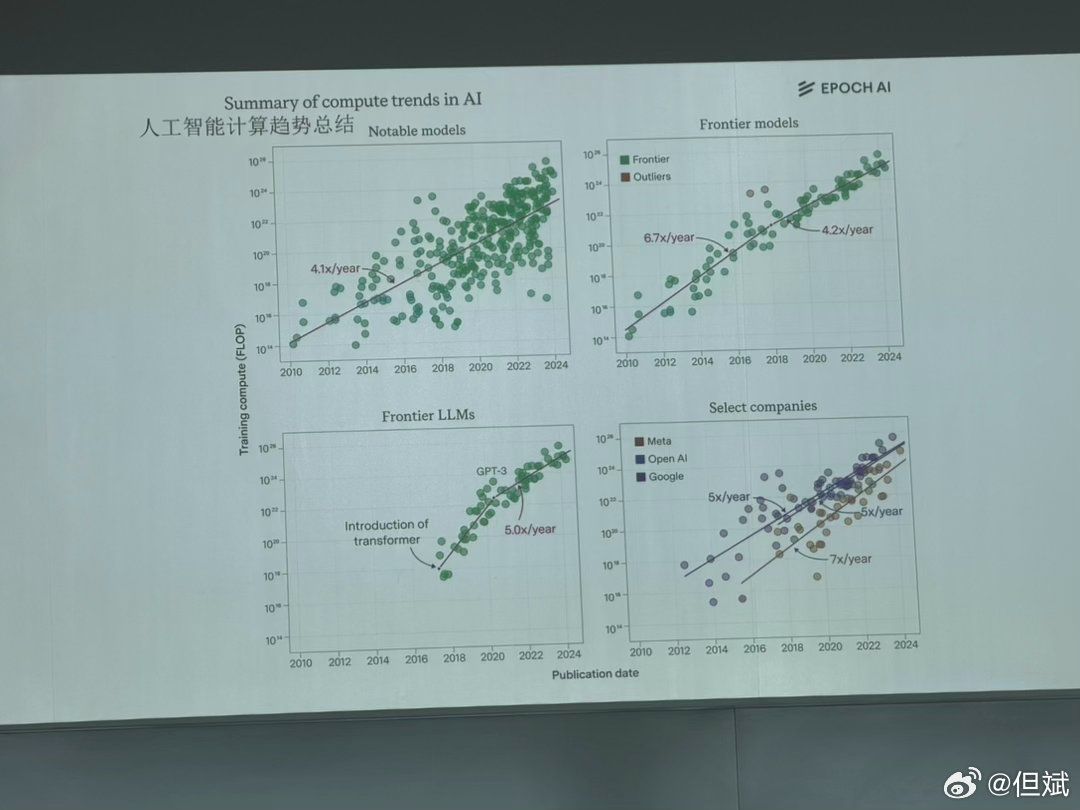
P30 人工智能计算趋势总结(Summary of compute trends in AI)· EPOCH AI
翻译:四个子图(纵轴为训练计算量 Training compute (FLOP),横轴为发表日期 Publication date,2010–2024):
- 知名模型(Notable models):4.1x/年
- 前沿模型(Frontier models,含 Frontier 和 Outliers 两类):前段 6.7x/年,后段 4.2x/年
- 前沿大语言模型(Frontier LLMs):5.0x/年,标注「引入 Transformer(Introduction of transformer)」和「GPT-3」
- 部分公司(Select companies:Meta、OpenAI、Google):三条趋势线分别标 5x/年、5x/年、7x/年(与公司的对应关系看颜色,图例区分度低【模糊】)
- 纵轴各刻度指数【模糊】
要点:前沿模型的训练算力大约每年增长 4–7 倍,和「每 6 个月翻一番」量级一致。
P31 全球数据量每 12 个月翻一番(Doubles every 12 months)
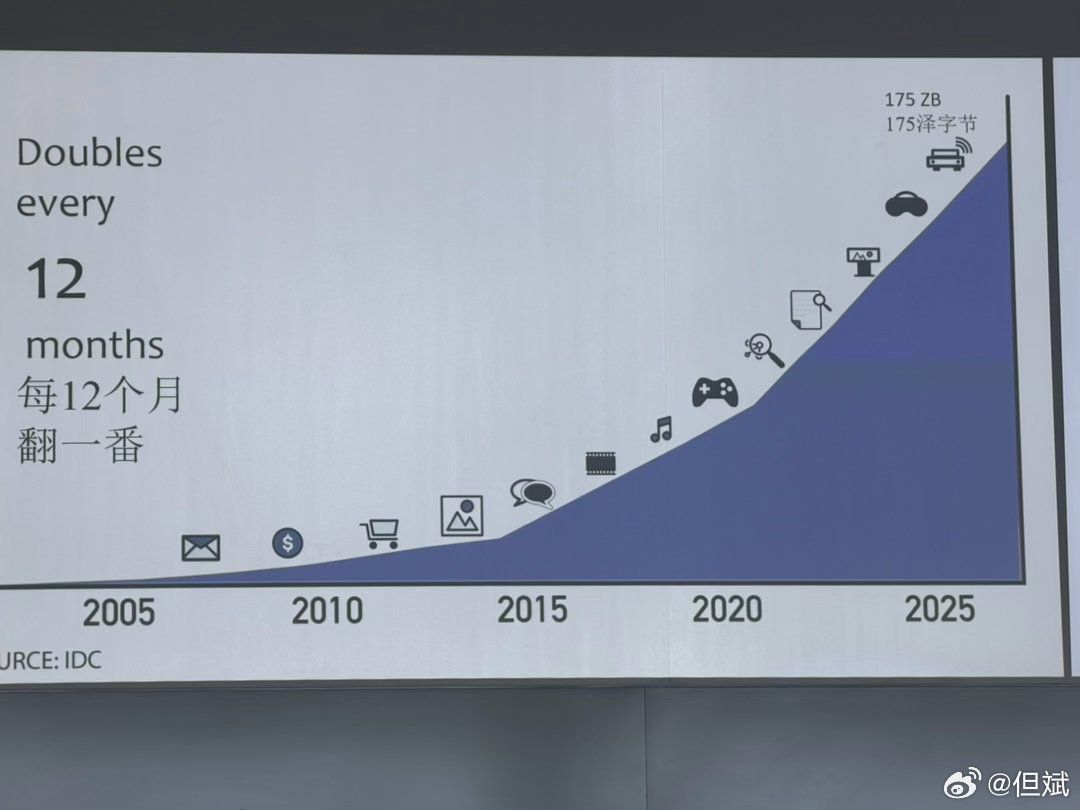
翻译:每 12 个月翻一番(Doubles every 12 months);到 2025 年约 175 ZB(175 泽字节)。来源:IDC(左下角,部分被裁切,可见「…URCE: IDC」)。
图表说明:2005–2025 年面积图。沿曲线依次是邮件、支付、购物车、图片、聊天、视频、音乐、游戏、搜索/分析、文档、广告牌、VR 眼镜、联网汽车等图标,表示数据来源在不断扩展。
要点:可供 AI 使用的数据(尤其是非结构化数据)也在指数增长,这是模型能力提升的燃料。
P32 AI 与人类性能基准对比(AI vs. Human Benchmarks)
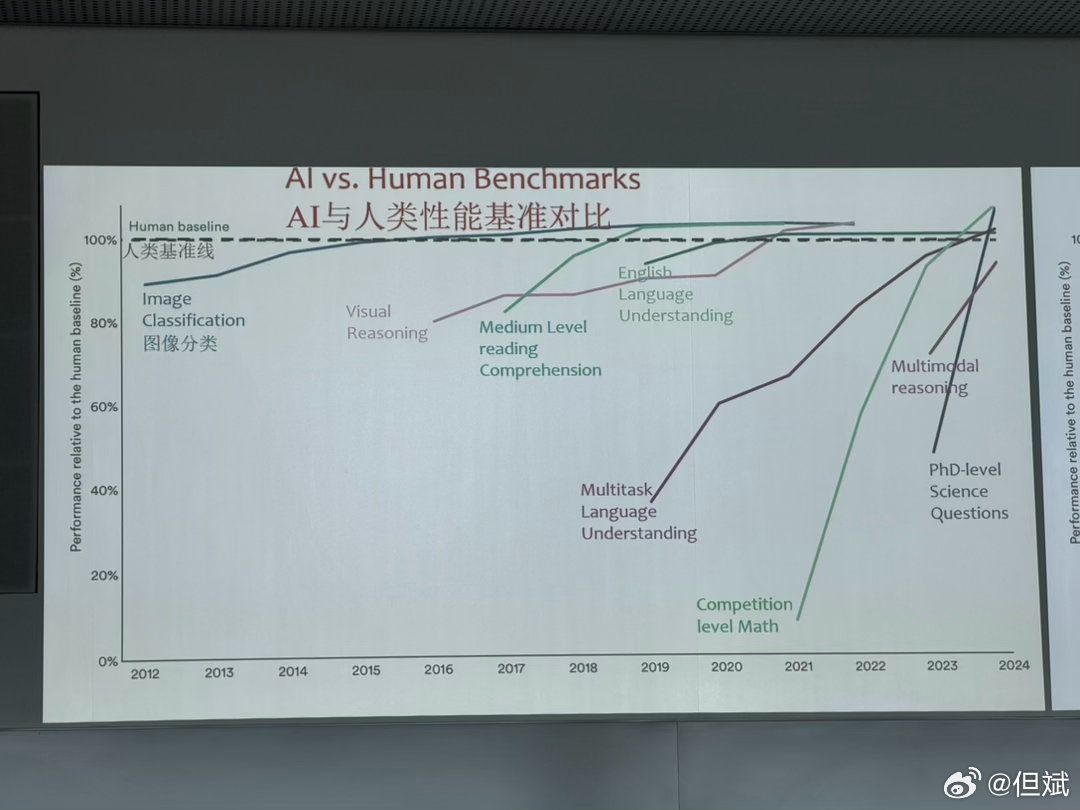
翻译:纵轴是相对人类基准线的表现(Performance relative to the human baseline, %),0–100%+;虚线为人类基准线(Human baseline)。横轴 2012–2024。各条曲线:
- 图像分类(Image Classification):约 2015 年达到人类水平
- 视觉推理(Visual Reasoning)
- 中等水平阅读理解(Medium Level reading Comprehension)
- 英语语言理解(English Language Understanding)
- 多任务语言理解(Multitask Language Understanding)
- 竞赛级数学(Competition level Math)
- 多模态推理(Multimodal reasoning)
- 博士水平科学问题(PhD-level Science Questions)
- 页面上没有看到来源标注
图表说明:越晚出现的基准(数学、博士级科学问题)曲线越陡,用两三年就从低位逼近或超过人类基准线。
要点:AI 赶上人类的速度在加快,新基准的「保质期」越来越短。
P33 从石器到……?(Stone Tools → ?)
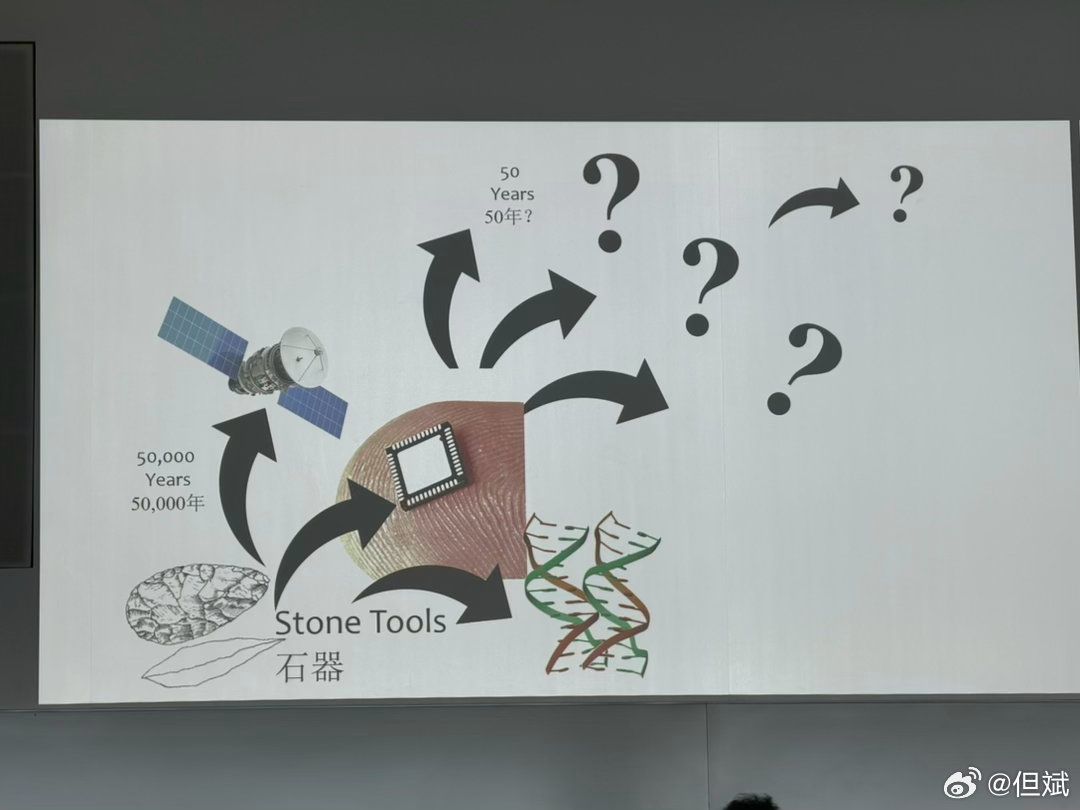
翻译:石器(Stone Tools)→(50,000 年 / 50,000 Years)→ 卫星;从「指尖上的芯片」出发,多个箭头指向 DNA 双螺旋和若干问号,标注「50 年?(50 Years?)」。
图表说明:示意图。人类花了五万年从石器走到太空技术,计算和生物技术可能在 50 年内带来同等量级、但还说不清方向的变化(问号)。
要点:这是收尾的展望页,讲变化的时间尺度被急剧压缩。
对投资 / 研究团队的启发(整理者观点)
以下是整理者根据课件归纳的看法,不是课件原文。
- 先投「管道」,再挑模型:同一个模型接上结构化数据源,准确率 94.2%;放在开放网络上只有 33.8%。团队应优先把公告、纪要、内部模型和研究邮箱通过 MCP 或 API 接成可追溯的数据源。在模型上的投入要可替换(model-agnostic),避免绑定单一厂商。
- 把投研方法论写成文件:参照 Oakcliff 的 MEMORY.md、六个研究框架和 wiki 校验,以及 RAMP 40 小时手册,把投资哲学、行业框架和检查清单落成文档,让每次 AI 调用都带着「公司记忆」,输出也回写进知识库。
- 从低风险、高频的环节试点:按「组合监控 → 财报分析 → 红队」的顺序,每个 agent 先用九行设计表立项,写清楚人工检查点、失效模式和 90 天指标。不要从涉及交易、资金或客户的环节开始。
- 引语和数字必须可追溯:AEO 案例说明,通用模型会编造管理层原话、给出带来源标注的错数字。凡是进入投资备忘录的引语和 KPI,都应附原文链接或页码,由人工抽检。
- 差异化认知仍然靠人:AI 默认输出共识。它最有用的地方是把基础尽调里约 23 小时的标准化工作和行业比价自动化,腾出时间给调研访谈、管理层沟通和长期跟踪,这些是剩下的 alpha 来源。也可以用「所有者视角」的问题,以及红队 agent,来逼 AI 跳出标准答案。
讲义中提到的外部数据来源 / 引用
| 来源 | 出现位置 | 内容 |
|---|---|---|
| Epoch AI | P29、P30(及帖四长文;第四部分出处存疑) | AI 训练算力趋势;自 2010 年约每 6 个月翻一番;各类模型每年 4.1x–7x |
| IDC | P31(及帖四长文;第四部分出处存疑) | 全球数据量约每 12 个月翻一番,2025 年约 175 ZB |
| Vals AI(Finance Agent v1.1,2026 年 3 月) | P12 | 各模型在核心金融分析任务上的准确率 |
| Daloopa retrieval benchmark | P12 | 有无结构化数据管道的提取准确率对比 |
| Kian Ghazi, How AI Will Compress Alpha in Fundamental Investing | P5 | alpha 来源 14→9→5 |
| Kris Bennatti + Internal Analysis | P9–P11 | GPT-5 分析 AEO 财报会的错误案例 |
| American Eagle Outfitters(AEO)IR 材料 / Q1 2025 财报电话会(May 29, 2025) | P9、P11 | 案例原始材料 |
| Bryan Lawrence(Oakcliff Capital),“Meet Marvin and Vicki, Our AI Agents at Oakcliff,” VALUEx BRK 2026, Omaha(May 1, 2026);Guy Spier YouTube 频道 | P19–P21 | Oakcliff 的智能体实践 |
| Marvin 的数据源:AlphaSense、Tegus、EDGAR、SEDAR、FMP、Google Drive、Web、Telegram | P20 | 研究数据输入 |
| OpenClaw(开源智能体) | P19、P20 | Marvin / Vicki 的运行框架 |
| Fundamental Edge「RAMP: Comprehensive」手册 | P17 | 40 小时公司入门流程 |
| Fisher(scuttlebutt 调研法) | P13 | 课件只写「Fisher」 |
| 摩尔定律图来源【模糊,疑为 Ray Kurzweil】 | P28 | 125 年计算价格性能 |
| 「Computing Speed Since 1900」图、「AI vs. Human Benchmarks」图 | P26、P27、P32 | 页面上未见来源标注 |
看不清 / 存疑内容汇总
- P6:副标题、上下排两个小标签、底部前半句看不清;四个方框里的小字是尽力转写。
- P9:GPT-5 回答截图字很小,引语大体可辨,个别词和第二条引语后的署名看不清;来源后半被裁切。
- P11:表格单元格下的来源小字看不清;右侧写「Q3'23」,与表中红叉所在行「Q4 FY23」不一致,原文照录。
- P12:副标题看不清;「领先的通用聊天机器人」和「同一前沿模型在开放网络」两项的数值看不清。
- P13:左下角脚注看不清。
- P14:副标题、右侧三条批评的正文、底部结论看不清,只有三个小标题可辨。
- P16:表格数字未逐格转写,只录了两行示例。
- P21:页码被裁切;记忆图谱节点小字看不清。
- P28:远距离拍摄,坐标刻度、机型名称、来源看不清。
- P29、P30:纵轴指数刻度看不清;P30 公司与趋势线的颜色对应看不清。
- 第四部分整体存疑:很可能出自另一堂课(推测为 Hod Lipson 的讲座),不是 Ehsani 本课。