LLM 高效架构综述
近年来,大语言模型(LLMs)展现出强大的语言理解与生成能力,推动了文本生成、代码生成、问答、翻译等任务的突破。代表性模型如 GPT、Claude、Gemini、DeepSeek、Qwen 等,已经深刻改变了人机交互方式。LLMs 的边界也不止于语言和简单问答。随着多模态(VLMs)与推理能力(LRMs)的兴起,LLMs 正不断扩展到多模态理解、生成与复杂推理场景。
但模型性能持续提升的背后,是模型尺寸、数据规模、RL 推理长度的快速 Scaling,是算力和存储资源的急剧消耗。大模型的训练与推理的成本居高不下,成为制约其广泛落地和应用的现实瓶颈。
本文从 LLM 架构角度出发,带你剖析大模型的效率秘诀。这一切的核心在于 Transformer 架构。Transformer 的自注意力机制虽带来了远距离建模的突破,却因 O(N2) 的复杂度在长序列任务中成本高昂。**而在 RAG、智能体、长链推理、多模态等新兴场景下,长序列需求愈发突出,进一步放大了效率与性能之间的矛盾。**同时 Transformer 的 FFN 部分采用密集的 MLP 层,同样面临模型规模放大后的训练和推理效率问题。
作者:机器之心
链接:https://zhuanlan.zhihu.com/p/1943373121248822632
论文标题:Speed Always Wins: A Survey on Efficient Architectures for Large Language Models论文地址:https://arxiv.org/pdf/2508.09834
项目仓库:https://github.com/weigao266/Aw
图 2:大语言模型高效架构概览
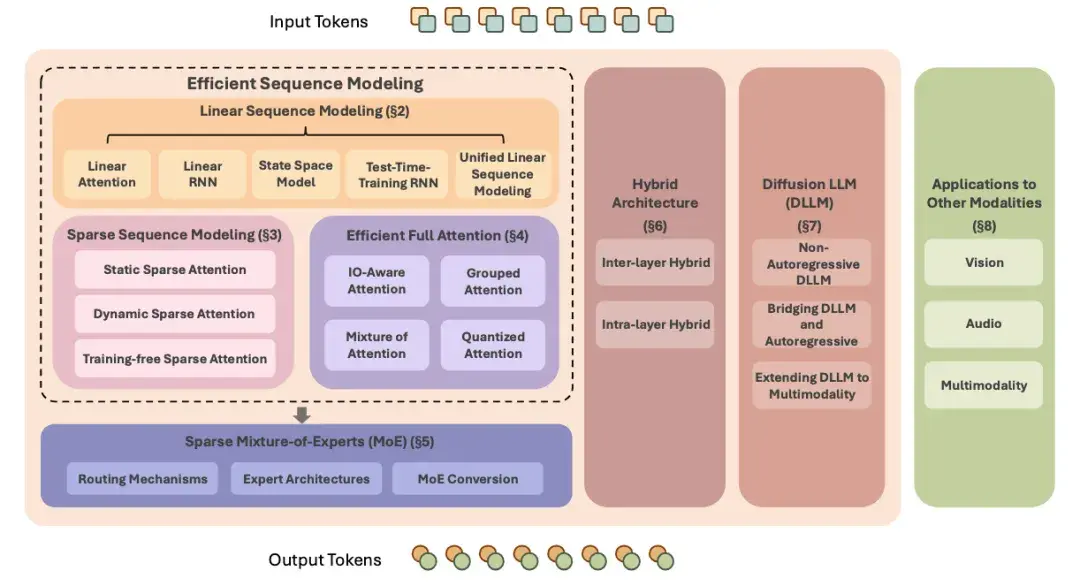
该综述将目前 LLM 高效架构总结分类为以下 7 类:
- 线性序列建模:降低注意力训练和推理复杂度,无需 KV Cache 开销。
- 稀疏序列建模:通过稀疏化注意力矩阵,降低计算与显存需求。
- 高效全注意力:在保持完整注意力的前提下优化内存访问与 KV 存储。
- 稀疏专家模型:通过条件激活部分专家,大幅提升模型容量而不增加等比例计算成本。
- 混合模型架构:结合线性/稀疏序列建模与全注意力,兼顾效率与性能。
- 扩散语言模型:利用非自回归的扩散模型进行语言生成。
- 其他模态应用:将这些高效架构应用于视觉、语音、多模态模型。
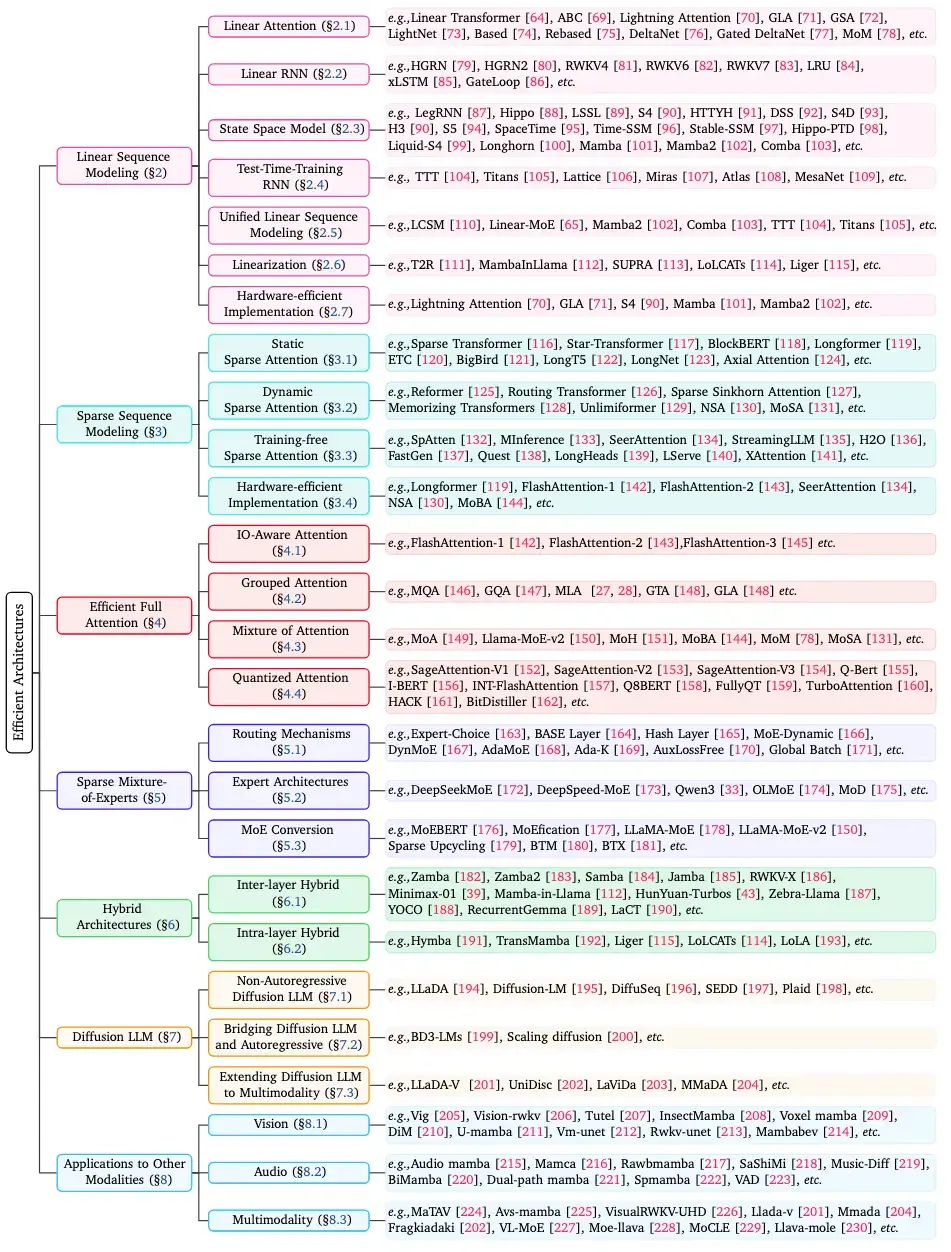
图 3:综述完整组织架构
作者:机器之心
链接:https://zhuanlan.zhihu.com/p/1943373121248822632
来源:知乎
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
线性序列建模
线性序列建模是近年来研究相当火热的一个方向,代表性工作像 Mamba、Lighting Attention、RWKV、GLA、TTT 等在模型架构方向都引起过广泛关注。我们将这类技术细分为以下几个类别:
- 线性注意力
- 线性 RNN
- 状态空间模型
- 测试时推理 RNN
并且正如在多篇文献里已经提出的,这些线性序列建模方法可以概括为统一建模的数学形式,并且能够通过线性化过程将预训练模型权重的 Softmax Attention 架构转为 Linear Sequence Modeling 架构,从而获得模型效率的大幅提升,如下图所示。
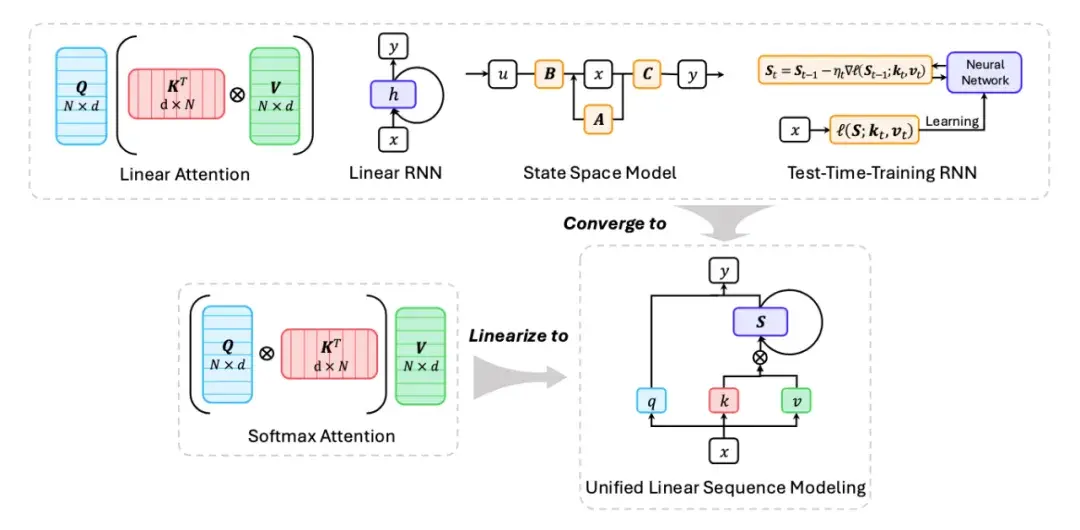
图 4:线性序列建模方法
我们将已有的线性序列建模方法从记忆视角和优化器视角分别进行梳理和对比,详细形式可见下表:
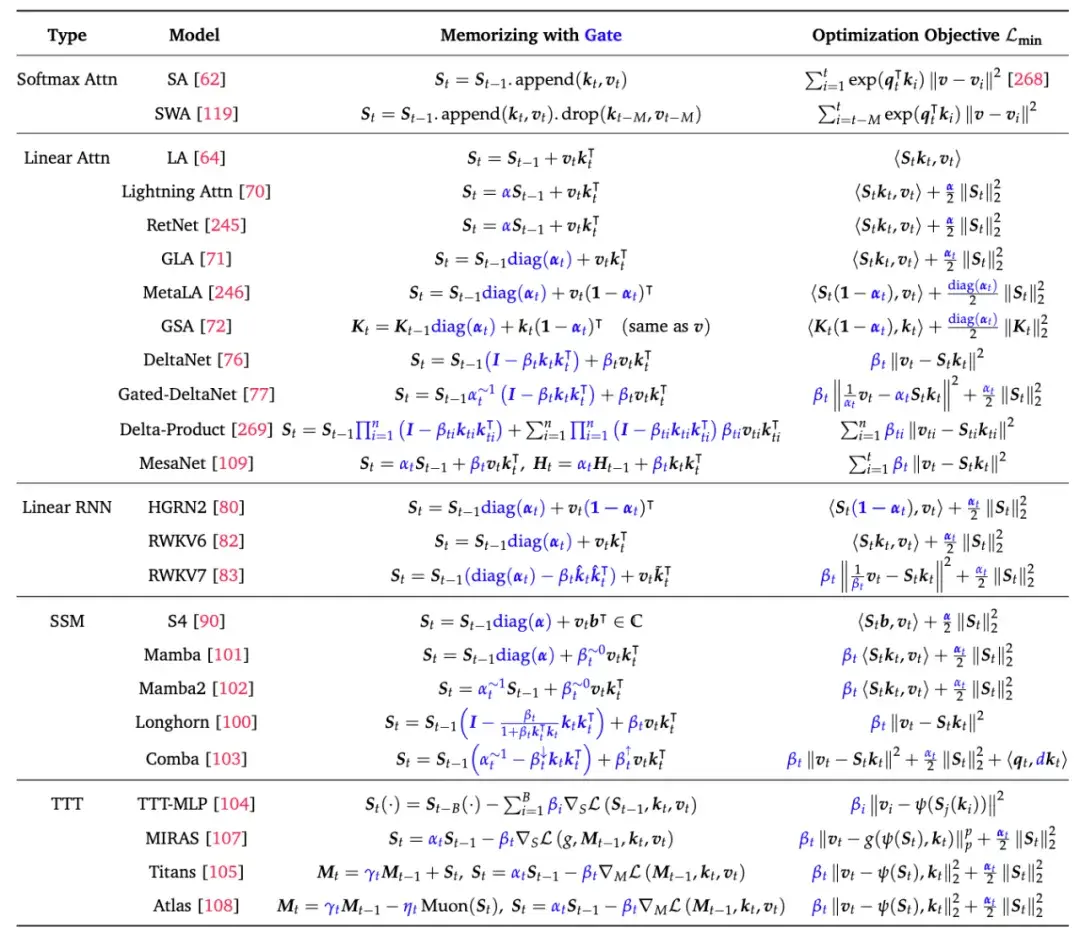
表 1:线性序列建模方法统一建模的 Memory 视角和 Optimizer 视角
其中线性化技术可以进一步细分为基于微调的线性化,和基于蒸馏的线性化,如下图所示:
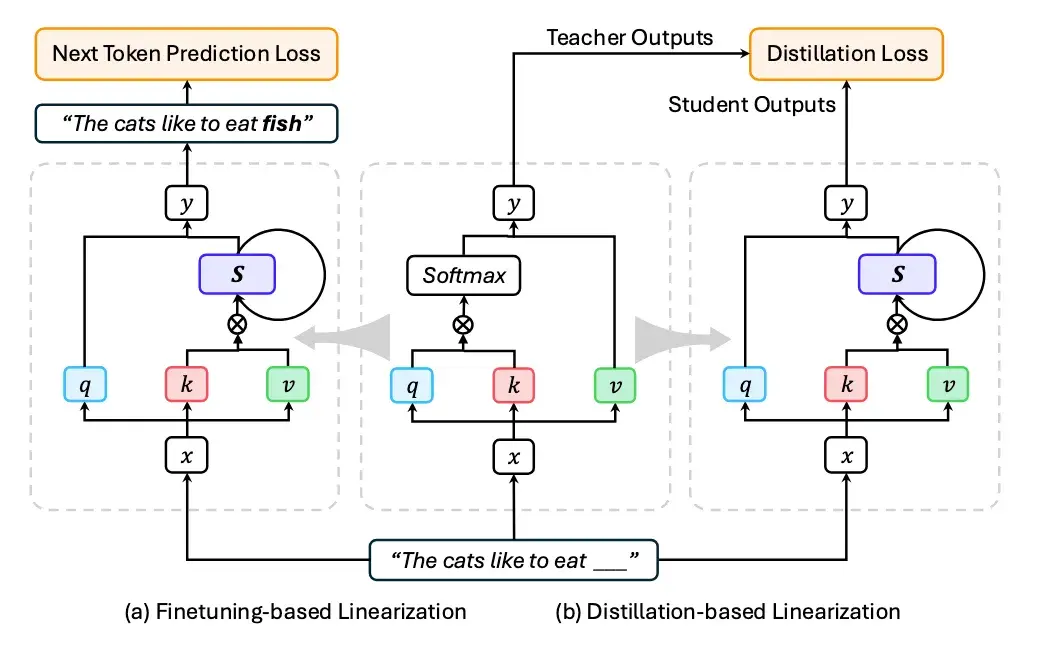
图 5:线性化方法
综述还进一步总结归纳了目前在线性序列建模领域常见的硬件高效实现方法,可以归纳为 Blelloch Scan、Chunk-wise Parallel 和 Recurrent for Inferences,如下图所示:
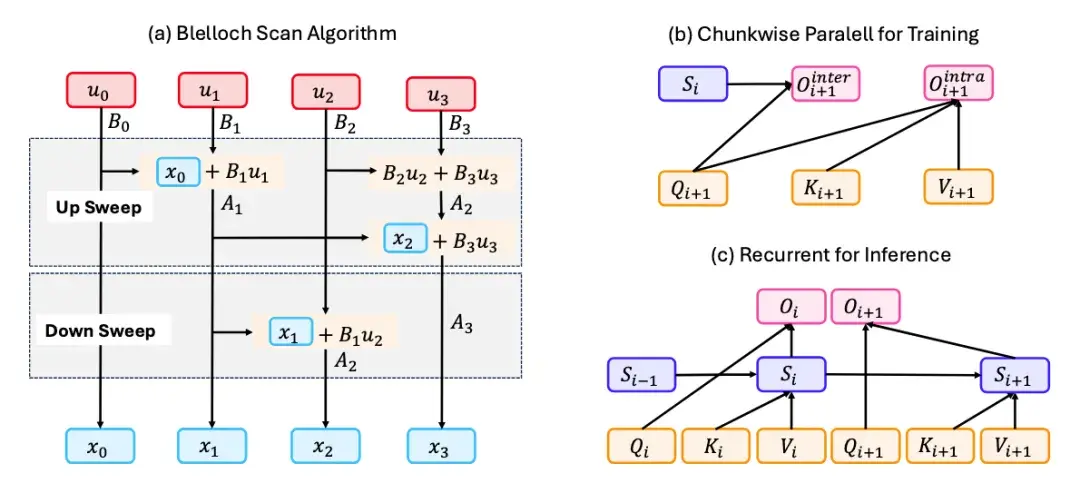
图 6:线性序列建模方法的硬件高效实现
稀疏序列建模
稀疏序列建模是另一类有代表性的高效注意力机制,通过利用 Attention Map 天然具有的稀疏性加速注意力的计算,这类方法可以进一步细分为:
- 静态稀疏注意力
- 动态稀疏注意力
- 免训练稀疏注意力
代表性的稀疏注意力方法如 Global Attention、Window Attention、Dilated Attention 等,及其工作原理如下图所示:
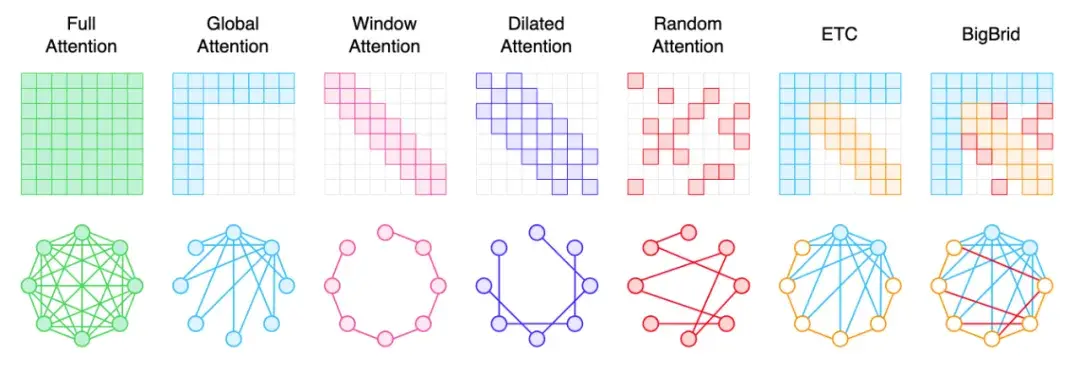
图 7:稀疏注意力的几种经典形式
高效全注意力
另一类高效注意力算法可以统一归纳为高效全注意力,这类方法可以根据算法思路进一步细分为如下几类:
- IO-Aware Attention
- Grouped Attention
- Mixture of Attention
- Quantized Attention
其中 IO-Aware Attention 指代目前使用非常广泛的 Flash Attention 系列工作,Grouped Attention 则包含广为使用的 GQA、MLA 等全注意力变体,几种代表性方法如下图所示。
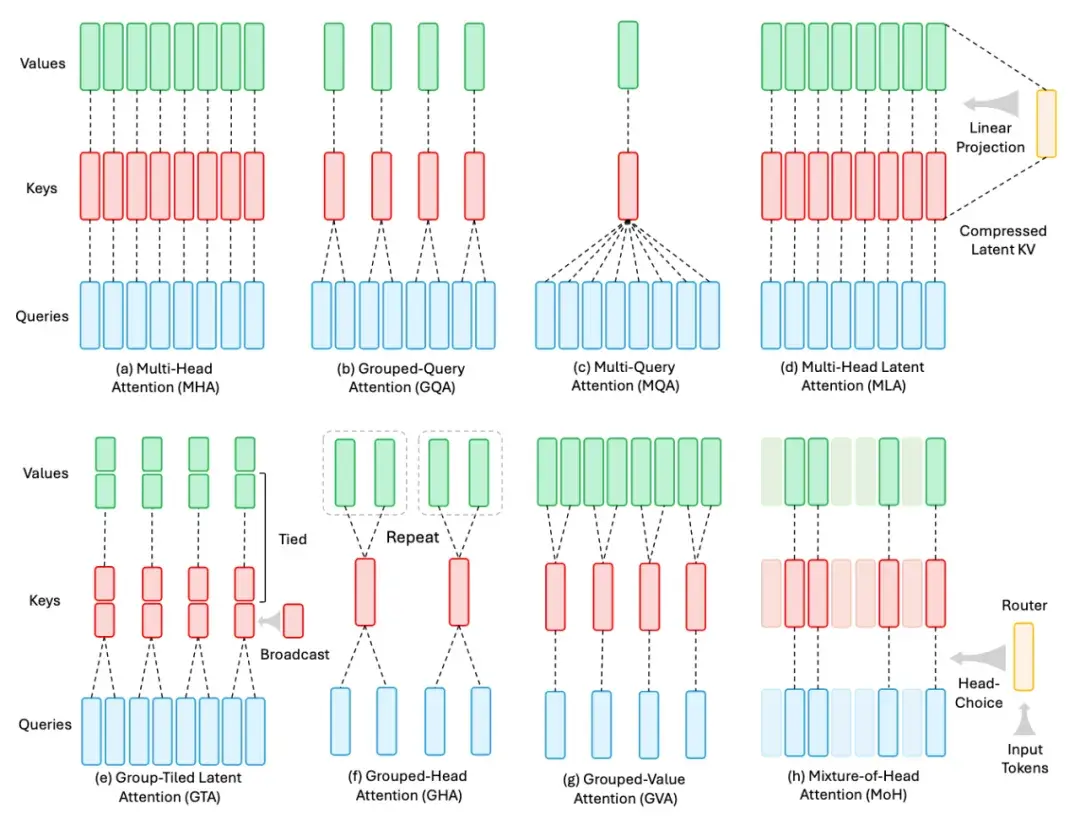
图 8:Grouped Attention 的几种代表性方法
稀疏混合专家
稀疏混合专家是对 Transformer 架构中另一个重要模块 FFN 做的一类重要改进,已经逐渐成为(语言和多模态)大模型架构的事实标准。综述中将相关文献按以下三个方向进行分类:
- Routing Mechanisms
- Expert Architectures
- MoE Conversion
路由机制包括 Token-choice 和 Expert-choice 两类,其原理如下图所示:
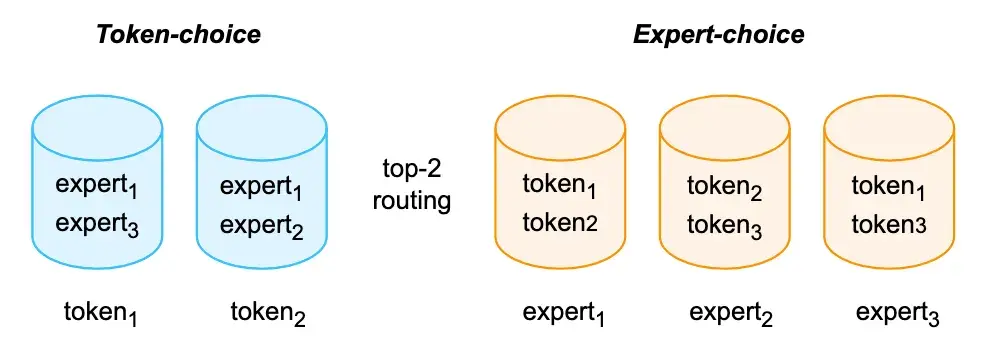
图 9:MoE 路由机制
专家结构的创新工作包括:共享专家、细粒度专家、零专家、深度路由等,其作用和原理可见下图:
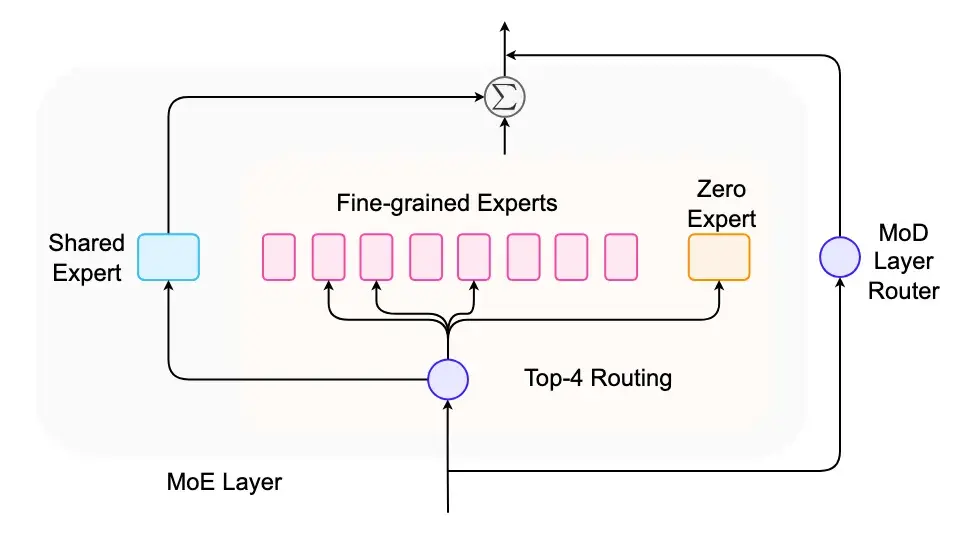
图 10:MoE 专家架构
另外一个重要的方向是 MoE 转换,已有的工作包括通过 Split、Copy、Merge 等手段对专家进行构造,如下图所示:
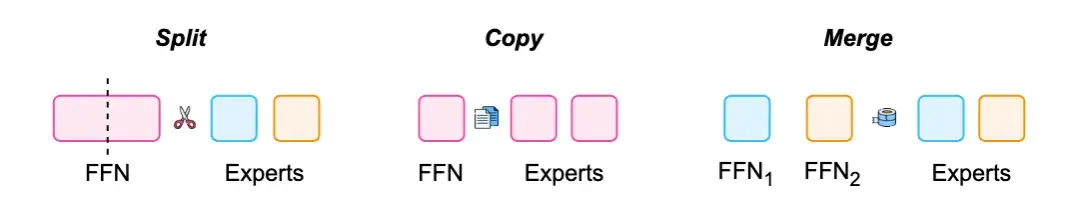
图 11:MoE 转化机制
混合架构
混合架构是近年来出现的一种实用的新型架构,可以在线性/稀疏注意力和全注意力之间取得微妙的 Trade-off,也在效率和效果间找到了最佳甜蜜点。具体可细分为:
- 层间混合
- 层内混合
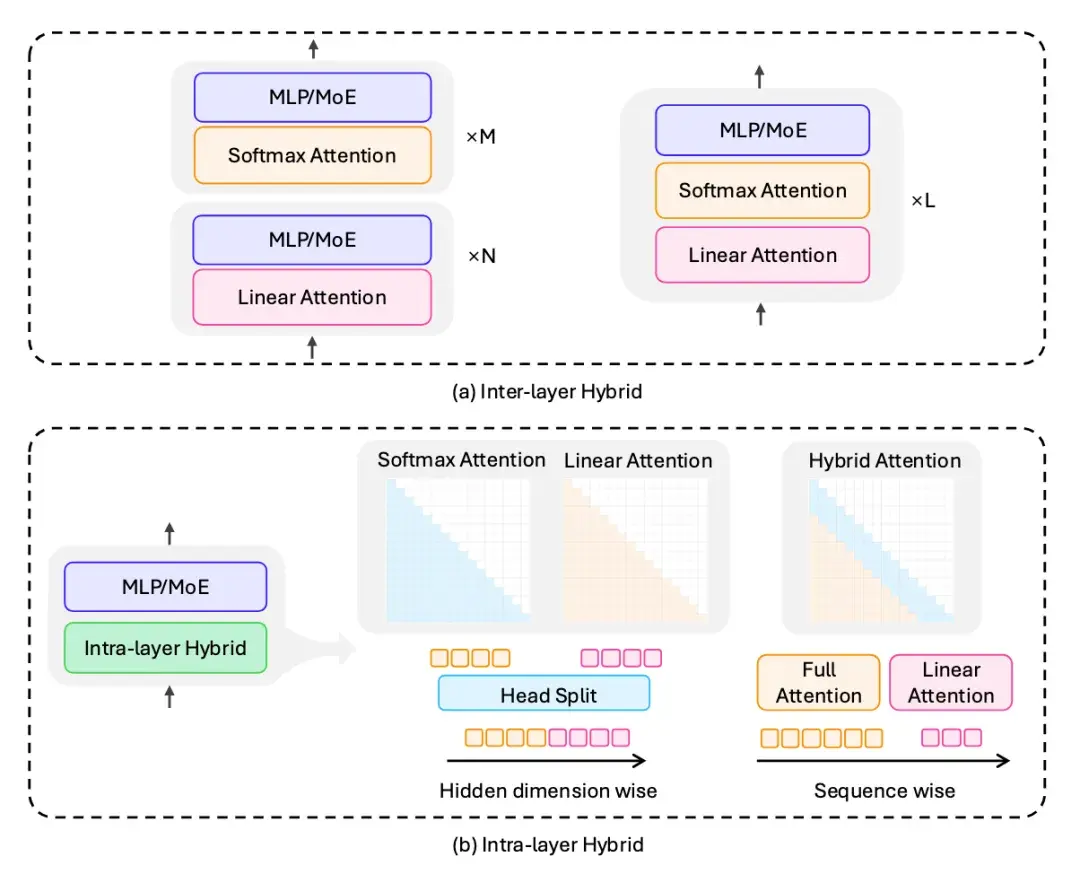
图 12:混合架构形式
扩散大语言模型
扩散大语言模型是近期出现的一个热门方向,创新性地将扩散模型从视觉生成任务迁移至语言任务,从而在语言生成速度上取得大幅进步。相关工作可以细分为:
- Non-Autoregressive Diffusion LLM
- Bridging Diffusion LLM and Autoregressive
- Extending Diffusion LLM to Multimodality
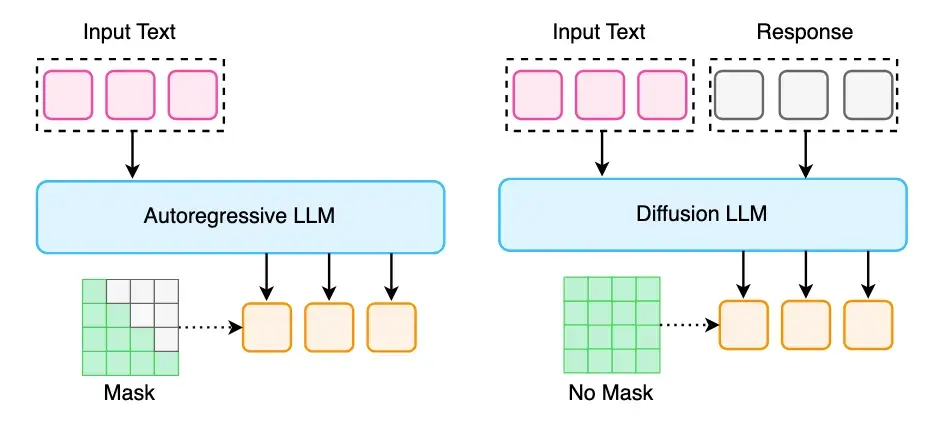
图 13:扩散大语言模型机制
应用至其他模态
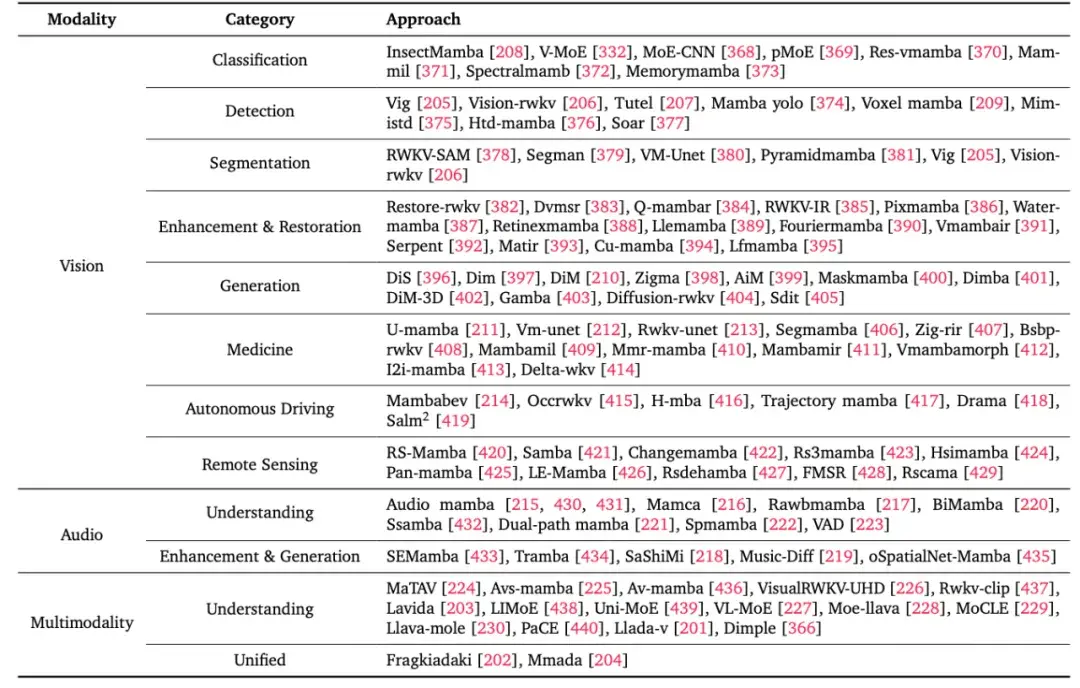
最后一个重要的部分是高效架构在其他模态上的应用,涵盖视觉、音频和多模态。以 Mamba 为代表的线性模型被广泛应用至多种模态任务上,并取得了优秀的表现,综述将这类模型总结梳理至如下表格:
历史评论(1,只读存档)
我先获取这篇论文的全文内容,再为你做总结和解读。【一句话速览】
这篇 70 页、300+ 引文的综述系统梳理了 2023-2025 年间「让大语言模型更快、更省」的七大技术路线,给出了从算法、系统到硬件的全景蓝图:线性化、稀疏化、MoE、扩散、混合……“速度永远是王牌”。
——————————————————————–
一、文章定位与贡献
1. 背景痛点
• Transformer 自注意力 O(N²) 复杂度在长上下文、多模态、推理链场景下导致训练/推理成本爆炸。
• FFN 参数量随模型规模线性增长,同样成为瓶颈。
2. 文章目的
不追求“更大”,而是“更聪明”——用更少的算力、更小的 KV-Cache 获得可比甚至更好的性能。
3. 核心贡献
① 首次把「线性序列模型」「稀疏注意力」「MoE」「扩散 LLM」等并置,给出统一符号体系与记忆-更新视角;
② 按 7 大类、50+ 子方向盘点 2023-2025 最新工作,含 150+ 模型/算法;
③ 给出跨模态(视觉、语音、多模态)迁移实例与落地建议;
④ 提供 GitHub 持续更新的 Awesome List(github.com/weigao266/Awesome-Efficient-Arch)。
——————————————————————–
二、技术路线图(文中图 1 的文字化)
1. 线性序列建模(Linear Sequence Modeling)
• 线性 Attention:Lightning Attention、GLA、ReBased …
• 线性 RNN:RWKV-4/6/7、HGRN2、xLSTM …
• 状态空间模型 SSM:Mamba-1/2、Comba、Longhorn …
• Test-Time-Training RNN:TTT、Titans、MesaNet …
→ 统一为「记忆矩阵 S 的线性/双线性/非线性更新」;可用 Blelloch Scan、Chunk-wise 并行加速。
2. 稀疏序列建模(Sparse Sequence Modeling)
• 静态稀疏:Longformer、BigBird、LongNet(1B token 训练)
• 动态稀疏:Reformer(LSH)、Routing Transformer(k-means)、NSA(硬件对齐)
• 训练无关稀疏:StreamingLLM、H2O、SeerAttention(推理期 KV-Cache 裁剪)
3. 高效全注意力(Efficient Full Attention)
• IO-Aware:FlashAttention-1/2/3(TMA/WGMMA 优化)
• Grouped:MQA、GQA、MLA、GTA(KV-cache 压缩 2-8×)
• Mixture-of-Attention:MoA、MoBA、MoSA(在 Head/Block/Token 级做路由)
• 量化注意力:SageAttention-INT8/4/FP4、INT-FlashAttention
4. 稀疏混合专家(Sparse MoE)
• 路由机制:Token-choice → Expert-choice → BASE → Hash → Ada-K/ReMoE(动态 k)
• 专家结构:细粒度小专家、共享残差专家、MoD(层粒度专家)
• 从稠密模型转化:MoEfication、Sparse Upcycling、BTX 合并多模型
5. 混合架构(Hybrid)
• Inter-layer:Zamba、Jamba、Samba、MiniMax-01(Mamba + Attention + MoE 交错)
• Intra-layer:Hymba(头间混合)、LoLCATs(序列段混合)
6. 扩散大模型(Diffusion LLM)
• 非自回归:LLaDA-8B(并行去噪,超越 Llama3-8B)
• 与 AR 融合:BD3-LM(块内扩散 + 块间 AR),DiffuLLaMA(把 Llama 微调成扩散)
• 多模态扩散:LLaDA-V、MMaDA(文本-图像统一扩散,支持 RL 训练)
7. 跨模态应用
• 视觉:ViG、Vision-RWKV、Mamba-YOLO、U-Mamba、Diffusion-Mamba 等
• 语音:Audio-Mamba、Dual-Path Mamba、Tramba(手机实时语音增强)
• 多模态:LIMoE、MoE-LLaVA、PaCE(任务级/LoRA 专家)
——————————————————————–
三、关键洞察与趋势解读
1. “线性化 ≠ 性能降”
通过 Delta 规则、测试时训练、混合窗口,线性模型在 Recall 任务上已逼近甚至超越 softmax attention。
2. “稀疏是万能膏药,但路由决定生死”
• 负载均衡损失 → 无辅助损失动态偏置(Lean Wang et al.)
• 全局批次平衡 → 避免微批次破坏专家专精(Qiu et al.)
3. “KV-Cache 压缩三件套”
量化(8/4-bit) + 稀疏(Top-k/H2O) + 共享(GQA/GTA) = 长文本 10-50× 显存节省。
4. “扩散 LLM 的 Aha Moment”
并行解码 + 双向上下文 → 推理延迟与长度解耦;RL-微调后推理能力追平 o1。
5. “算法-系统-硬件共设计”
• Triton kernels(FlashLinearAttention、NSA) → 5-16× 实测加速
• Hopper GPU 的 TMA/WGMMA 让 FlashAttention-3 再提 1.5-2×
——————————————————————–
四、未来方向(文中 9 节提炼)
1. 超大规模:万亿参数 MoE + 分层 KV-Cache(SRAM↔HBM↔CPU)
2. 端侧部署:1-3B 稀疏/量化/蒸馏小模型,支持 100 token/s 手机推理
3. 无限长上下文:Log-Linear Attention + 压缩记忆 + 动态缓存淘汰
4. 实时智能体:流式线性 RNN + 事件驱动 KV-Cache 更新
5. 统一多模态:离散扩散 + MoE + 跨模态路由,实现「一次前向,多模态输出」
——————————————————————–
五、一句话总结
当算力红利见顶,「结构效率」成为大模型继续 Scaling 的主战场——这篇综述就是新战场的作战地图。